Dockerでイメージを取得してからコンテナが動くまでに何が起きているのか

Webアプリケーション開発では、手元の開発環境や本番環境など、たいていどこかでコンテナを使います。自分もなんとなく使っていますが、コンテナが動く仕組みについて十分に説明できないことに気づきました。そこで、仕組みを一から追ってみることにしました。

イメージの取得からコンテナが動作するまでに動くプログラム(全体像)

この記事で扱う範囲

扱うのは、docker pullでイメージを取得してから、docker runでコンテナのプロセスが動き出すまでの範囲です。そのあいだに、どのプロセスが何をしているかを調べてみました。

1章と2章はdocker pull、3章と4章はdocker runの実行時に起きたことです。

コンテナを動かしているLinuxカーネルの機能については、詳細な挙動には言及せず、一般的な概念を書くにとどめます。

登場するプログラムとその関係

docker pullとdocker runの実行時に動くプログラムと、それぞれの関係を図にしました。各プログラムが何かは、次章以降の最初に出てくる場面で説明します。
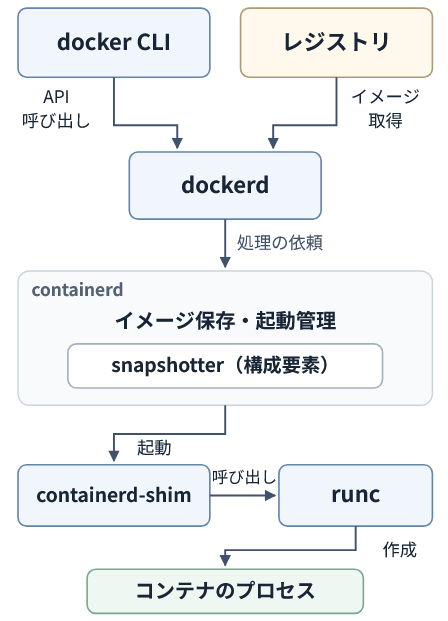
図

動作環境

  • Mac(Apple M4、macOS 26.7.1)。CPUはarm64です
  • Docker Desktop 4.56.0、Docker Engine 29.1.3
  • イメージの保存をcontainerdに任せ、取得にもcontainerdのライブラリを使う仕組みを使っています。Dockerはこれをcontainerd image storeと呼び、Docker Desktopでは標準で有効です。設定画面での名前は「Use containerd for pulling and storing images」です。この仕組みを使っていない環境では、記事中に登場するディレクトリと異なります
  • 例としてalpine:3.20とpostgres:16の2つのコンテナを使用します。

コンテナの動作環境

Linuxのコンテナは、Linuxのカーネル上で動きます。そのため、MacのDocker Desktopは、Macの中に小さなLinuxのVMを立ち上げ、そのVMのカーネルでコンテナを動かします。
本記事の実行例は、このVMの中で実験したものです。

1. イメージを取得する

docker pullを実行すると、Dockerはレジストリからイメージを取得します。レジストリとは、コンテナイメージを保管・配布するサーバーです。代表的なものはDocker Hubで、alpine:3.20のように名前だけを指定すると、Dockerは自動的にDocker Hubからイメージを取ってきます。

イメージの中身を見てみる

イメージの形式を規定しているのは、OCI(Open Container Initiative)という団体のImage Specという仕様です。Dockerは、Docker独自の形式(Image Manifest Version 2, Schema 2)も扱えますが、この記事ではOCIの形式で説明します。この記事で例に使うalpine:3.20とpostgres:16も、OCIの形式です。

OCIのイメージは、次の4種類のファイルでできています。(イメージによってはindexがない場合もあります。)

ファイル 何が書かれているか
index プラットフォームごとのmanifestの一覧です。複数のプラットフォーム向けに配るイメージで使われます。
manifest 1つのプラットフォーム向けのイメージに使うファイルの一覧です。configが1つと、layerが重なり順に複数並びます。
config コンテナを起動するときの設定です。実行するコマンドや環境変数などが入ります。
layer(レイヤー) ファイルシステムの差分をまとめたtarで、gzipやzstdで圧縮されていることもあります。下層のlayerから順に重ねることで、コンテナから見えるファイルシステムになります。

レイヤーは、Dockerfileでイメージを作る際に作成されます。RUNやCOPYなどの命令を実行するたびに1つずつ生成され、各レイヤーは差分情報だけを持ちます。

4種類のファイルの関係を図示すると、こうなります。
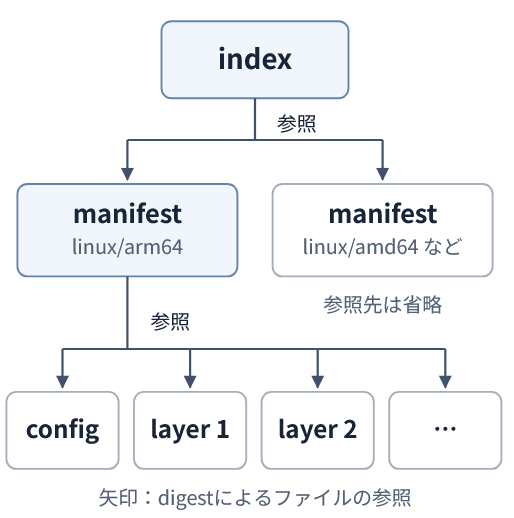
図

イメージを構成するファイルの参照には、digest(ファイルの中身から計算したハッシュ値で、通常はsha256)が使われています。indexには各manifestのdigestが、manifestにはconfigとlayerのdigestが書かれています。

digestと一緒に、リンク先が何のファイルかを表す名前も書かれており、これをメディアタイプと呼びます。

実際のイメージを見てみましょう。私が取得したindexのdigestは

sha256:d9e853e87e55526f6b2917df91a2115c36dd7c696a35be12163d44e6e2a4b6bc

でした。

indexの中身は、次のコマンドで見られます。

docker buildx imagetools inspect --raw alpine:3.20

alpine:3.20のindexには、8つのプラットフォームのmanifestが並んでいました。arm64のmanifestを指す部分は次のとおりです。

...
{
  "schemaVersion": 2,
  "mediaType": "application/vnd.oci.image.index.v1+json",
  "manifests": [
    // ほかのプラットフォームは省略
    {
      "mediaType": "application/vnd.oci.image.manifest.v1+json",
      "digest": "sha256:45e09956dc667c5eff3583c9d94830261fb1ca0be10a0a7db36266edf5de9e1d",
      "size": 1026,
      "platform": { "architecture": "arm64", "os": "linux", "variant": "v8" },
      // annotationsは省略
    },
  ],
}
...

digestに書かれているのがarm64のmanifestを指すdigestです。mediaTypeには指す先がmanifestであること、platformにはそのmanifestがarm64向けであることが書かれていました。

次にmanifestを取得してみましょう。

docker buildx imagetools inspect --raw alpine@sha256:45e09956dc667c5eff3583c9d94830261fb1ca0be10a0a7db36266edf5de9e1d

manifestには次のように書かれています。

...
{
  "schemaVersion": 2,
  "mediaType": "application/vnd.oci.image.manifest.v1+json",
  "config": {
    "mediaType": "application/vnd.oci.image.config.v1+json",
    "digest": "sha256:ab3fe4defd29ba6231229a4d41440ac8bde8218e85870e53876277faa24b35c4",
    "size": 628,
  },
  "layers": [
    {
      "mediaType": "application/vnd.oci.image.layer.v1.tar+gzip",
      "digest": "sha256:3f26bc2dec0b515f1c2818f6e13a8f1da1f88179a008445d4e587233386bff78",
      "size": 4092319,
    },
  ],
  // annotationsは省略
}
...

configのdigestにconfigファイルの、layersのdigestにlayerファイルのdigestがそれぞれ書かれていました。alpine:3.20に含まれるlayerは1つでした。

indexとmanifestに出てきたmediaTypeをまとめると、次のようになっていました。

ファイル メディアタイプ
index application/vnd.oci.image.index.v1+json
manifest application/vnd.oci.image.manifest.v1+json
config application/vnd.oci.image.config.v1+json
layer application/vnd.oci.image.layer.v1.tar+gzip

また、ここまで見てきたmanifestとは別に、それと対になるattestation manifestという補足情報を表すmanifestも含まれていました。
そのうちSBOMには、イメージに入っている、またはビルドに使ったソフトウェアの一覧が記録されています。provenanceにはイメージがどうビルドされたかが記録されています。
これらはplatformがunknown/unknownになっています。また、annotationのvnd.docker.reference.typeがattestation-manifestになっていることからも識別可能です。

dockerdがレジストリからイメージを取得する

docker pullの実行時、dockerコマンド(docker CLI)は自分でイメージを取得するわけではなく、Docker Engine本体のデーモンであるdockerdのAPIを呼び出します。

デーモン(daemon)・・・裏で動き続けて要求を待つプロセス。dockerdも、次に登場するcontainerdも、名前の最後にデーモンを表す「d」が付いています。

docker CLIからの要求を受けたdockerdは、レジストリと通信してファイルを取得します。取得したファイルはcontainerdに送られ、containerdがディスクに保存します。containerdはイメージの保管と、コンテナの作成・起動・停止を行うデーモンです。

このときdockerdは、containerdが提供するクライアント用ライブラリを使って、containerdと通信します。

取得したファイルの保存先

取得したファイルは、containerdがレジストリから受け取った形のままディスクに保存します。gzipで圧縮されているレイヤーも、この時点では展開しません。保存時のファイル名には、そのファイルのdigestからsha256:を除いた16進数の文字列が使われます。

indexには各manifestのdigestが、manifestにはconfigと各レイヤーのdigestが記録されています。そのため、indexのdigestが同じなら、そこから参照されるmanifest、config、レイヤーもすべて同じ内容です。

自分のプラットフォームのmanifestに関わるファイルだけが取得される

実際にpullしてみると、containerdが保存していたのは、indexと、arm64向けのmanifest、config、layerのみでした。標準では、indexの中から自分のプラットフォームのmanifestだけを選んで取得するため、ほかの7つのプラットフォーム用のmanifestは保存されません。

また、内部的には、arm64のmanifestと対になるattestation manifestと、その先のSBOMとprovenanceも一緒に取得していました。
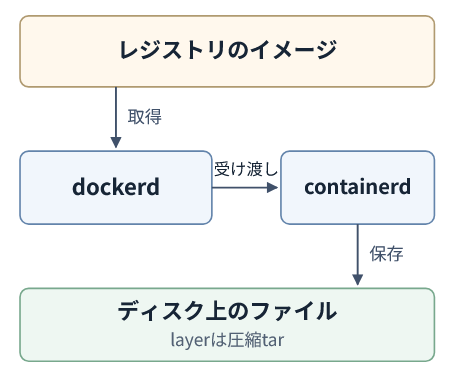
図

ここまでで、イメージのindex、manifest、config、layerが、containerdによってディスクに保存されました。ここではまだ、layerは圧縮されたtarのままであることに留意してください。

2. レイヤーを展開する

1章で取得したレイヤーファイルは、まだgzipで圧縮されたtarのままです。ディレクトリに展開する必要があります。
展開先のディレクトリを管理するのは、containerdの中のsnapshotterというコンポーネントです。snapshotterには複数の方式がありますが、この記事の動作環境ではoverlayfsという方式が使われていました。

展開先のディレクトリ

展開はpullを実行した時点で行われ、io.containerd.snapshotter.v1.overlayfs/snapshotsの下に、レイヤーごとに1つずつ展開先のディレクトリが作られます。

postgres:16では、1つ目のレイヤーのディレクトリにOSの基本のディレクトリ(bin、boot、dev、etcなど)が入っていました。2つ目以降のディレクトリに入っているのは差分ファイルです。具体的には、そのレイヤーで追加や更新したファイルと、ファイルを削除したことを表す特殊なファイルが展開されます。この特殊なファイルについては、この章の後半で紹介します。

どのプログラムがレイヤーを展開するか

レイヤーを展開する役割を担うのはcontainerdですが、内部ではsnapshotterとdiffという2つのコンポーネントが処理を分担します。
まず、保存用ディレクトリの準備をするのはsnapshotterです。diffはtarアーカイブを受け取り、ファイルシステムの差分をディレクトリに反映します。その後、snapshotterが完了時のコミットを行います。

これらの処理を呼び出すのは、dockerd内で使われているcontainerdライブラリです。
なお、ディレクトリのマウントの指定もsnapshotterが行います。ただしoverlayFS(後述)で2層目以降のレイヤーを展開するケースではマウントを実行せず、準備したディレクトリへ直接解凍が行われます。

レイヤーでファイルを削除したときの扱い

レイヤーは差分なので、前のレイヤーにあったファイルの削除も取り扱います。消したファイルはレイヤー上でどう取り扱われるのかを、次のDockerfileで実際にイメージを作って確かめました。

FROM alpine:3.20
RUN echo secret > /secret.txt
RUN rm /secret.txt

echoのRUNでできたレイヤーにはsecret.txtが入りました。後のレイヤーで削除しても、前のレイヤーのファイルは削除されません。Dockerfileで削除したファイルも、イメージからは取り出せるということです。

一方、rmのRUNでできたレイヤーには、secret.txtを消したことを表す特殊なファイルが入っていました。このファイルはwhiteoutと呼ばれます。レイヤーのtarアーカイブの中では、削除したファイルの名前の前に.wh.を付けたファイル名で記録されます。今回は.wh.secret.txtとして記録されていました。

レイヤーを展開する際には、containerdは、whiteoutをまた別の形の特殊なファイルに書き換えます。デバイス番号が0, 0のキャラクタデバイスです。キャラクタデバイスとは本来、端末などの装置をファイルとして読み書きできるようにする特別なファイルですが、デバイス番号の0, 0はどの装置にも割り当てられない番号なので、このファイルはどの装置も指しません。

少し話を先取りすると、次の第3章では、OverlayFSと呼ばれる、複数のディレクトリを重ねて1つに見せるLinuxカーネルの機能が登場します。OverlayFSは、上の層にこの0, 0のキャラクタデバイスを見つけると、下の層のディレクトリにある同じ名前のファイルを非表示にします。こうしてコンテナのファイルシステム上でファイルの削除が反映されます。

さて、話の流れを元に戻します。
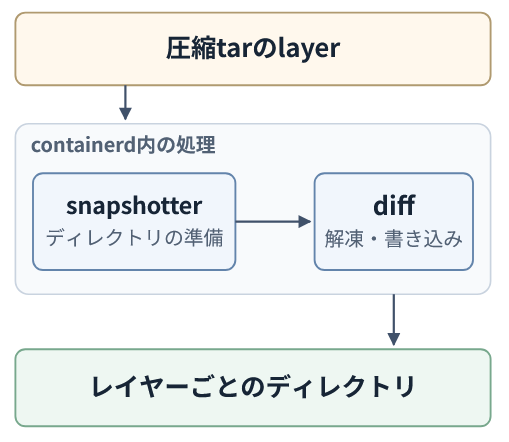
図

ここまでで、各レイヤーが1つずつ別のディレクトリに展開されました。ただ、ディレクトリはレイヤーごとに分かれたままです。

3. レイヤーを重ねてファイルシステムを作る

ここからはdocker runについての話になります。
2章で展開したレイヤーは、レイヤーごとに別のディレクトリに入っています。しかしコンテナからは、これが1つのファイルシステムに見えなければいけません。そこで、先ほど出てきたOverlayFSを使い、ディレクトリを重ねて1つに見せます。

ここで重ねるのは、次の3種類のディレクトリです。

  • 2章で、コンテナイメージのレイヤーを展開したディレクトリ
  • コンテナごとの-initの層のディレクトリ
  • コンテナが書き込む層のディレクトリ

このうち、一番目を除いた2つは、イメージには含まれないコンテナごとのディレクトリです。

dockerdがディレクトリを重ねる

まずsnapshotterがコンテナの書き込み先となるディレクトリを作成し、その後dockerdにマウントの指示をします。

それを受けてdockerがOverlayFSを使って3種類のディレクトリをマウントします。マウント先は/var/lib/docker/rootfs/overlayfs/<コンテナID>です。これはcontainerdの保存先ではなく、dockerdの保存先である/var/lib/dockerの下でした。

コンテナの作成完了時点では、このマウントは解除されています。コンテナを起動すると、マウントされます。

ディレクトリの重なり方

2章のイメージから作ったコンテナのマウントは、次のようになっていました。<snapshots>は、2章で見た展開先のio.containerd.snapshotter.v1.overlayfs/snapshotsです。

lowerdir=<snapshots>/8211/fs   コンテナごとの-initの層
         <snapshots>/8195/fs   RUN rm /secret.txt のレイヤー
         <snapshots>/8194/fs   RUN echo secret > /secret.txt のレイヤー
         <snapshots>/8111/fs   alpine:3.20のレイヤー
upperdir=<snapshots>/8212/fs   コンテナが書き込む層
workdir=<snapshots>/8212/work

ディレクトリが重なる順は、下から、イメージのレイヤー、コンテナごとの-initの層、コンテナが書き込む層です。

-initの層を見てみると、/etc/hosts、/etc/resolv.conf、/etc/hostname、/.dockerenvなどの空のファイルと、/dev配下の空のディレクトリなどが入っていました。

このうち/etc/hosts、/etc/resolv.conf、/etc/hostnameの3つは、起動時に別のファイルをマウントするための場所です。Dockerはコンテナごとにこれらの設定ファイルを用意し、コンテナの起動時に、それぞれ対応するパスにマウントします。その結果、コンテナからは、空のファイルではなく、Dockerが用意したコンテナごとの設定ファイルの内容が見えるようになります

また、同じイメージからもう1つコンテナを作ってみると、別のディレクトリになったのは-initの層と書き込む層だけで、イメージのレイヤーは同じディレクトリを使っていました。同じイメージから作ったコンテナどうしは、イメージのレイヤーを共有しているということです。

OverlayFSの挙動を確かめる

OverlayFSは、lowerdirに指定されているディレクトリを読み取り専用で重ねる一方、書き込みについてはupperdirに指定したディレクトリに反映します。

本当にそうなるのかを、動いているコンテナで、ファイルを読み込み/書き込み/削除をして確かめました。

  • /etc/os-releaseを読み込み: upperdirには何も増えない
  • /etc/motdに1行追加: upperdirにetc/motdのコピーができ、そこに変更が入った
  • /etc/issueを削除: upperdirに、2章で見た削除ファイルの形でetc/issueが置かれた

書き込み時も削除時も、lowerdirにあるコンテナイメージのレイヤーのetc/motdとetc/issueは元のままでした。同じイメージから作った別のコンテナからも、元のまま見えました。この結果から、書き込みや削除はupperdirに行われることが検証できました。
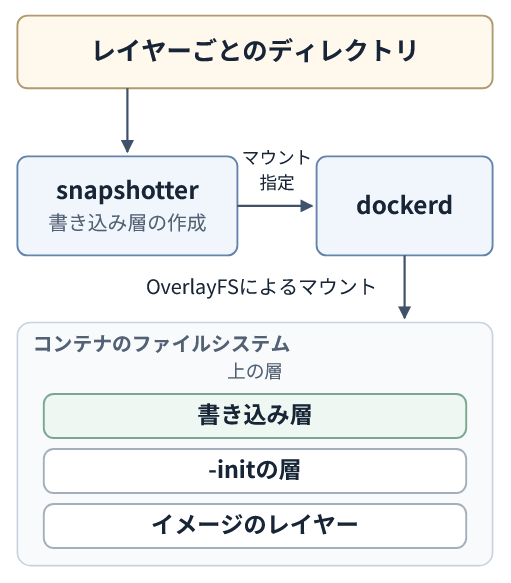
図

ここまでで、コンテナのルートになるファイルシステムができあがりました。しかし、まだ、その上で動くプロセスはありません。

4. プロセスを隔離して起動する

ファイルシステムができたので、最後はコンテナのプロセスを起動します。

起動の順序

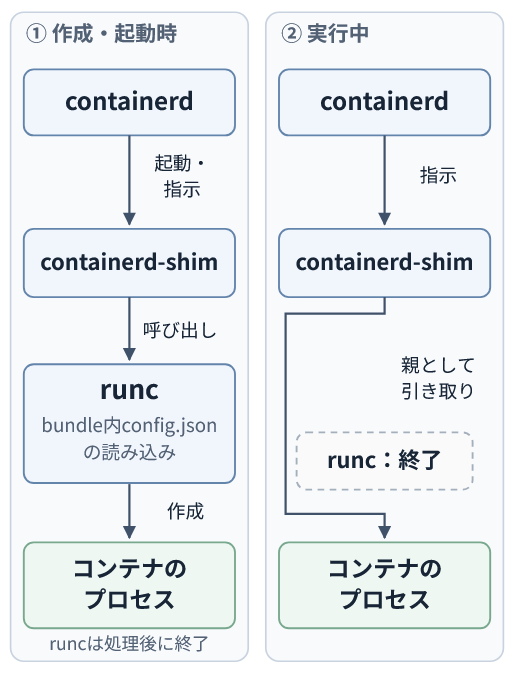
ここで新しく出てくるのが、runcとcontainerd-shimです。2つの関係を、次の図にまとめました。
図

runc

runcは、OCIの仕様に沿って、Linuxの上でコンテナを作成・起動するコマンドラインツールです。Dockerが標準の設定でコンテナを動かす時は、このruncが使われます。1章で見たイメージの形式はOCIのImage Specで決まっていましたが、コンテナの動かし方もOCIのRuntime Specで決まっており、runcはそれにしたがって実装されています。

runcに渡す設定は、bundleと呼ばれるディレクトリにまとめられます。その中のconfig.jsonには、実行するプログラムなどの設定と、コンテナのルートファイルシステムの場所を示すroot.pathが書かれています。

root.pathには絶対パスも指定でき、今回の環境では、3章でdockerdがマウントした、bundleの外にあるディレクトリを指していました。つまり、3章で用意したファイルシステムを、4章のruncに引き渡す役目を果たすのが、このconfig.jsonです。

containerd-shim

containerdはruncを直接呼び出すのではなく、containerd-shimというプロセスを介して呼び出します。Dockerの標準設定では、コンテナごとに1つのcontainerd-shimが動きます。

containerd-shimには複数の種類があり、runcを使うときにはcontainerd-shim-runc-v2が使われます。containerdはこのプロセスが待ち受けるソケットを通して、コンテナの作成・起動・停止を指示します。

このように間にcontainerd-shimを挟むことで、OCIのRuntime Specに沿った別のランタイムが組み込みやすくなります。また、containerd-shimは、後述するようにコンテナのプロセスの親となり、コンテナの実行中も動き続けます。

実際に動いた順序とプロセスの親子関係

docker runの実行中に動くプロセスをカーネルのトレースで記録しました。すると、containerdがcontainerd-shimを起動し、containerd-shimがruncを呼んで、runcがコンテナのプロセスを作る様子を見ることができました。

詳しく見ると、containerd-shimは2段階で起動していました。最初のcontainerd-shimは、指示を待ち受ける別のcontainerd-shimを起動して終了します。その後、containerdとの通信やruncの呼び出しは、待ち受け用のcontainerd-shimが担当します。

このcontainerd-shimは、runcをrunc createとrunc startの2回に分けて呼び出します。

  • runc create:コンテナのプロセスを作成する
  • runc start:作成したプロセスに、コンテナのコマンドの実行を開始させる

作成されたプロセスは、同じプロセスID(PID)のまま、実行するプログラムをコンテナのコマンドに切り替えていました。それぞれのruncコマンドは、処理が完了すると終了します。

runcが終了すると、コンテナのプロセスは親プロセスが終了した状態になります。親が先に終了して残された子プロセスは、孤児プロセス(orphan process)と呼ばれます。孤児プロセスは、OSが決めた特別なプロセスに引き取られます。Linuxでは通常pid 1のプロセスがその役目です。

ところが、containerd-shimは、subreaperというLinuxの機能を使用し自分の子孫の孤児プロセスを引き取る設定になっています。そのためruncが終わって孤児になったコンテナのプロセスは、pid 1ではなく、containerd-shimの子に付け替えられます。

runcがプロセスに設定する隔離と制限

runcは、Linuxカーネルの機能を組み合わせてプロセスを隔離し、制限します。どう制限するかを決めるのはdockerdです。どのnamespaceを分けるか、どのcapabilitiesを渡すか、どのseccompのプロファイルを使うかをdockerdが組み立ててcontainerdに渡し、containerdがそれをbundleのconfig.jsonに書き出します。runcは、そのとおりにカーネルの機能を使います。

機能 何をするか 実行例で見たこと
namespace プロセスから見えるものを分ける pid、net、mnt、uts、ipc、cgroupの6つがVMと分かれていた。userとtimeは分かれていなかった
cgroups 使える量を制限する --memory、--pids-limit、--cpusで指定した量が、上限として設定された。付けなければ、上限は設定されなかった
capabilities rootの権限を細かく分け、一部だけ渡す コンテナに渡された権限は、VMのpid 1より少なかった
seccomp 呼べるシステムコールを絞る コンテナはSeccomp: 2で、フィルタが掛かっていた

コンテナの中から見てみると、3章で3種類のディレクトリを重ねて作ったファイルシステムがルートディレクトリ(/)に見えていました。
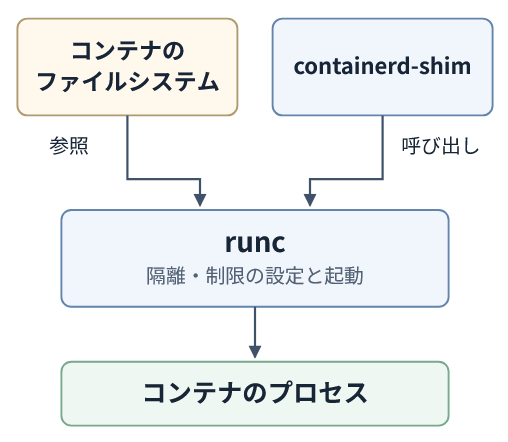
図

こうして、コンテナのプロセスが隔離された状態で動き出しました。その親は、containerd-shimです。

まとめ

docker pullとdocker runの裏側では、次の順に処理が進みます。

  1. dockerdがレジストリから、自分のプラットフォームのmanifestとそのリンク先のファイルを取得し、containerdに渡す。containerdは、受け取ったファイルをディスクに保存する
  2. 展開先のディレクトリをsnapshotterが作り、containerdがレイヤーを1つずつ展開する。
  3. dockerdが、展開したレイヤーのディレクトリと、コンテナごとのディレクトリを、OverlayFSで重ねてマウントする
  4. containerd-shimがruncを呼び、runcがnamespaceやcgroupsなどでプロセスを隔離して起動する。runcは終了し、コンテナのプロセスはcontainerd-shimの子になる

プログラムごとに見ると、役割は次のように分かれていました。

プログラム この記事で見た役割
dockerd レジストリからファイルを取得する。ディレクトリを重ねてマウントする。プロセスの隔離と制限をどう設定するかを決める
containerd 取得したファイルを保存する。レイヤーを展開する。containerd-shimを起動する。config.jsonを書き出す
snapshotter 展開先のディレクトリと、コンテナが書き込む層のディレクトリを作る
containerd-shim runcを呼ぶ。動いているコンテナのプロセスの親になる
runc カーネルの機能でプロセスを隔離し、コンテナのプロセスを作る

コンテナの正体は、ディレクトリを重ねて作ったファイルシステムの上で、カーネルの機能で隔離されて動く、普通のプロセスだということがわかりました。
似顔絵
書いた人:金子

AIがアプリを操作する時代のモバイルアプリ設計~ロジックを画面から切り離すことの必要性

モバイルアプリを使用する際、必ずしも人間が操作するとは限らない時代になってきました。人間の指示を受けたAIがアプリの機能を呼び出し、使用するケースが今後もっと増えていくことでしょう。

9月14日に配信されたiOS 27では「Siri AI」が登場、これまでのSiriよりも一層賢くアプリの機能を呼び出せるようになりました(配信時点では英語のみで、beta という位置づけです)。Androidにも AppFunctions があり、こちらはライブラリがまだ alpha で対象アプリも限られていますが、一部の端末・アプリでは実際に呼び出せます。

このようにAIがアプリを操作するようになったときに、モバイルアプリのインターフェースと設計はどう変わるのでしょうか。

結論からいうと、アプリの入口が画面だけではなくなるので、ロジックを画面から切り離しておくことが必須になるのではないか、と思っています。

※この記事でいう「インターフェース」は画面(GUI)に限らず、人間やAIがアプリの機能と相互にやり取りする接点全般を指します。

アプリを操作するのは「人間」から「人間 or AI」に

これからは、アプリを操作する主体として以下の2つを想定する必要があります。

  • 人間が操作する。これまでどおり、人間が画面から操作する
  • AIが操作する。人間がAIに目的を伝え、AIがアプリの機能を呼ぶ

※この記事内で「AIが操作する」と表現する際は、アプリが宣言した機能をAIが直接呼び出す場合に限定します。(ブラウザを自動で動かすエージェントのように、AIが人間用の画面をクリックしていくケースは含めません)

この変化は、UIの歴史の中で大きな区切りにあたります。ウェブユーザビリティ研究の第一人者であるヤコブ・ニールセン(Jakob Nielsen)は、コマンドライン、テキスト端末、GUI を、どれも「人間がコマンドでひとつずつ操作する方式」と分類しています(AI: First New UI Paradigm in 60 Years)。見た目は変わっても、人間がひとつずつ指示する点は60年変わっていない、ということです。

ところが、AIの登場により、人間が最終目的だけを指示する方式が登場しました。人が直接一つ一つの操作を行うことはなく、一連の機能の呼び出しはAIに任せられます。

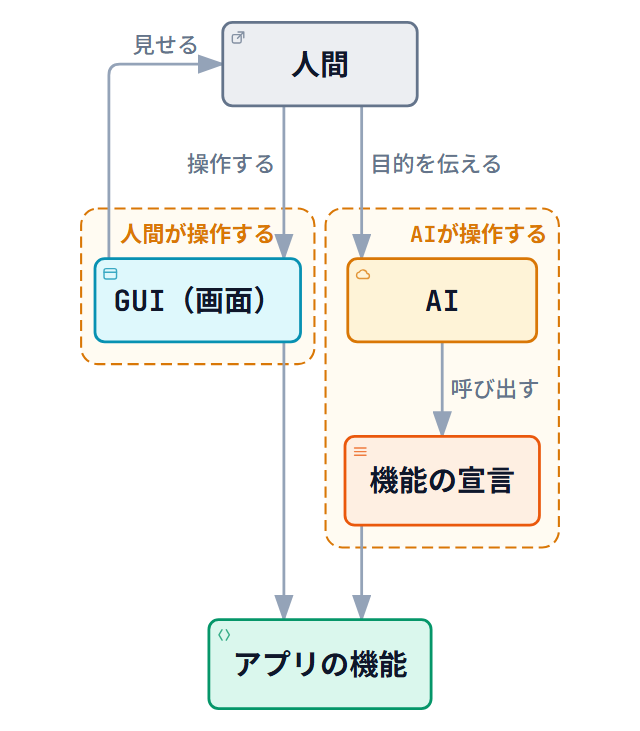
このような操作の流れを「経路」と呼びましょう。人間が操作する経路と、AIが操作する経路を図にまとめるとこのようになります。

図1: 人間が操作する経路と、AIが操作する経路

人間が操作する経路では、人間は画面を通じてアプリの機能を呼び出します。AIが操作する経路では、人間の指示をもとにAIが画面を通さずにアプリの機能を呼び、その結果も画面を通さずにAIが受け取ります。

AI・アプリ間のインターフェースの変遷

このときAIが使用できる機能は、アプリ側があらかじめ宣言した機能に限られます。AIにとっては、この「機能の宣言」が、アプリの入口となるわけです。

このAI側から見たアプリの入口について、もう少し詳しく見ていきましょう。
AIはどうやってアプリの機能を呼ぶのか
iOSを例に説明します。あなたがSiriに指示を出したとき、Siriはこんなふうに機能を探します。

  • iOS 16(2022年): Siriは、アプリ開発者があらかじめ準備した想定フレーズに照らし合わせて機能を呼び出します。Apple のドキュメントでも "preconfigured"(あらかじめ設定された)shortcut と書かれています
  • iOS 18(2024年): アプリの宣言に書かれた機能名や説明をApple Intelligence が読むため、Siriはユーザーの自由な言葉遣いの指示をもとに、呼び出す機能を選べるようになりました。

iOS 27 の新しいSiriも、iOS 18と同じような仕組みの上で動いています。また、AndroidのAppFunctionsも考え方は近いものです。

つまり、「決められた呼び出し方に一致させる」方式から、「アプリ側の機能の宣言を読み、ユーザーの自然な指示にあわせて適切な機能を選ぶ」方式へ移ってきた、と考えることができます。

このように、AI側の機能の呼び出し方法は大きく変わりました。一方で、アプリ側はどうでしょうか。アプリ側の「機能の宣言」についても見ていきましょう。

アプリはどう機能を宣言してきたか

アプリ側が書く宣言の形は、実は2022年から変わっていません。iOSでは App Intents と呼ばれ、名前、説明、型付きの引数、という形です。iOS 18 以降、Siriから呼ばせるにはAppleが定義したスキーマに準拠させる記述を足す必要がありますが、基本的な中身は同じです。iOS27でもそれは同じで、WWDC26 のセッション「Build intelligent Siri experiences with App Schemas」でも「それを可能にしている土台が App Intents です」と説明されています。

ところで、この「名前・説明・型付きの引数」という形は、MCP(Model Context Protocol)のtool定義とほぼ同じです。並べてみます。

//Swift

struct RecordTemperatureIntent: AppIntent {
    static let title: LocalizedStringResource = "体温を記録"
    static let description = IntentDescription("体温を記録します")

    @Parameter(title: "体温")
    var temperature: Double

    func perform() async throws -> some IntentResult & ProvidesDialog {
        // アプリの機能を呼ぶ
        return .result(dialog: "\(temperature)度を記録しました")
    }
}

// MCP

{
  "name": "record_temperature",
  "title": "体温を記録",
  "description": "体温を記録します",
  "inputSchema": {
    "type": "object",
    "properties": {
      "temperature": { "type": "number", "description": "体温(℃)" }
    },
    "required": ["temperature"]
  }
}

どちらも、名前・説明・型付きの引数が書かれています。呼び出す側がここに書かれた説明をヒントに実行する機能を選択し、引数に何を入れるかを決める点も同じです。もちろんMCPサーバとApp Intents/AppFunctions は別物ですが、宣言の形は非常に似ていると言えます。

宣言の中身はそれだけではない~結果の返し方、認証

ここまでだと、AI用のインターフェースは「呼べる関数の一覧」に見えます。ただ、App Intents の宣言に書くのは、呼べる機能だけではありません。次の2つも宣言の一部です。

  1. 結果をどう返すか
  2. 認証をかけるか

1つ目は、結果の返し方です。さきほどのSwiftのコードにある ProvidesDialog は、実行後に返す文言の宣言で、それを受け取ったシステムが表示または読み上げる想定です。文言ではなく画面で返す ShowsSnippetView もあり、どちらもiOS 16からあります。iOS 26 で追加された SnippetIntent を使うと、返した画面の中でユーザーが選択肢を選んだり情報を確認したりできます。

AI時代のUIとして GenUI や A2UI という言葉を見かけますが、これは返す画面をAIがその場で組み立てるものです。一方でSnippetIntent で返す画面は、AIが作ったものではなく、アプリの開発者が書いたSwiftUIのビューです。出てくる場所は SnippetIntent と同じですが、画面を用意するのがアプリか、AIかという違いがありますね。

ちなみに、この画面はここまで分けて考えてきた、人間が操作する経路とAIが操作する経路、そのどちらかに属するものではありません。どちらの経路にも、AIが人間に応答するタイミングで登場します。たとえ経路が分かれていても、人間に見せる画面は結局どちらからも必要になる、ということです。

そして2つ目は、認証です。画面からの操作手順の中でかけていた認証は、画面を通らない経路には自動ではかからないことに注意すべきです。AIからは、ログイン画面の先にあるはずの機能でも、intentごとに設定しない限り認証なしで呼べてしまいます。モバイルアプリのセキュリティ診断を手がける NowSecure も、認証のポリシーはintentに自動適用はされないと指摘しています(原文: "Authentication policies are not automatically applied to every intent."、2026年8月)。

このことはまたあとで出てきます。

呼び出し元の数に応じてロジック層を切り出す

冒頭に「アプリの入口が画面だけではなくなるので、ロジックを画面から切り離しておくことが必須になるのではないか」と書きました。

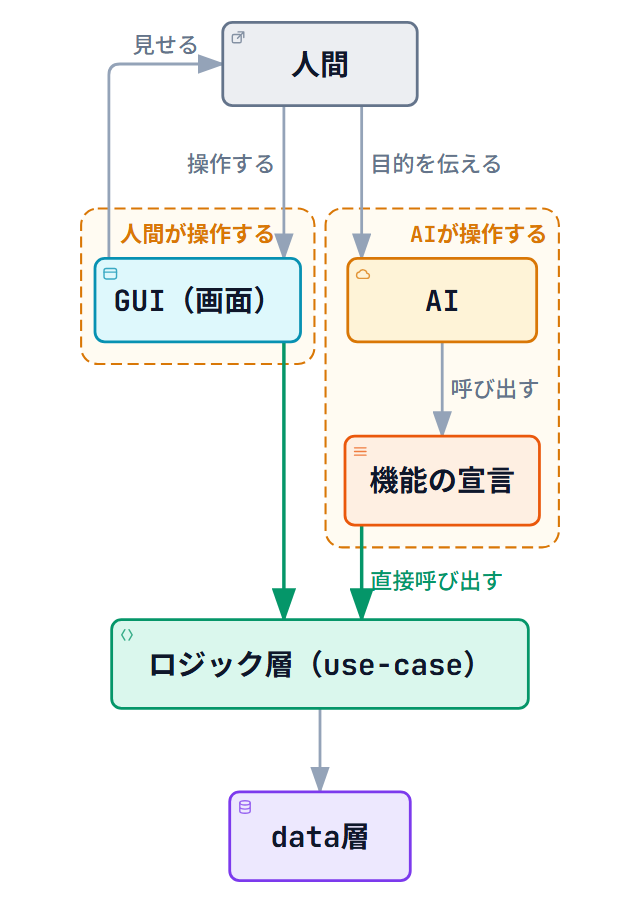
今後は、AIが使う経路と人間が使う経路の両方から、同じ機能を呼び出すことになります。ということは、ロジックは両方から呼べる共通の場所に置かなければいけません。

先ほどの2つの経路の図を、アプリの内部まで広げて描くとこうなります。

図2: 同じ2つの経路を、アプリの内部まで広げたもの

ロジックの呼び出し元が2つになり、片方は画面を通らない、という点に注目してください。

では具体的にどのような設計にしたらいいのか。弊社ではモバイルアプリを Flutter で作っているので、Flutter に当てはめて考えてみます。Flutter の公式ドキュメント(App architecture guide)では、ドメイン層(use-case)は "Optional" として扱われていて、入れる条件が3つ挙げられています。

複数のリポジトリのデータを合わせる必要がある(Requires merging data from multiple repositories)
非常に複雑である(Is exceedingly complex)
そのロジックを別の ViewModel から使い回す(The logic will be reused by different view models)

推奨のページでは推奨度が "Conditional" で、"ほとんどのアプリでは、不要なオーバーヘッドを増やしてしまう(in most apps they add unnecessary overhead)" とまで書かれています。

これは一見「小さいアプリなら、UI層とdata層の2層で十分」だと読めるのですが、そういうことではありません。

注目したいのは3つ目の項目です。「別の ViewModel から使う」と書かれているのは、ロジックを呼ぶのが ViewModel だけだという前提があるからです。App Intents や AppFunctions は、ViewModel ではない呼び出し元です。条件を文字どおりに読むと、「呼び出し元は1つの ViewModel だけなので、use-case は要らない」と判断してしまいますが、これからは画面がない場所からロジックを呼ぶことも想定しなければいけないのです。

といっても、公式ガイドが間違っていると指摘したいわけではなく、呼び出し元が増えた前提で、同じ条件を読み直す必要がある、という話です。

つまり、やるべきことは3つあり、

  • UI層とdata層の間に use-case を置く
  • 画面からは ViewModel を通して呼び、機能の宣言からは use-case を直接呼び出す
  • ViewModel は、読み込み中やエラー表示など、画面の状態だけを持つ

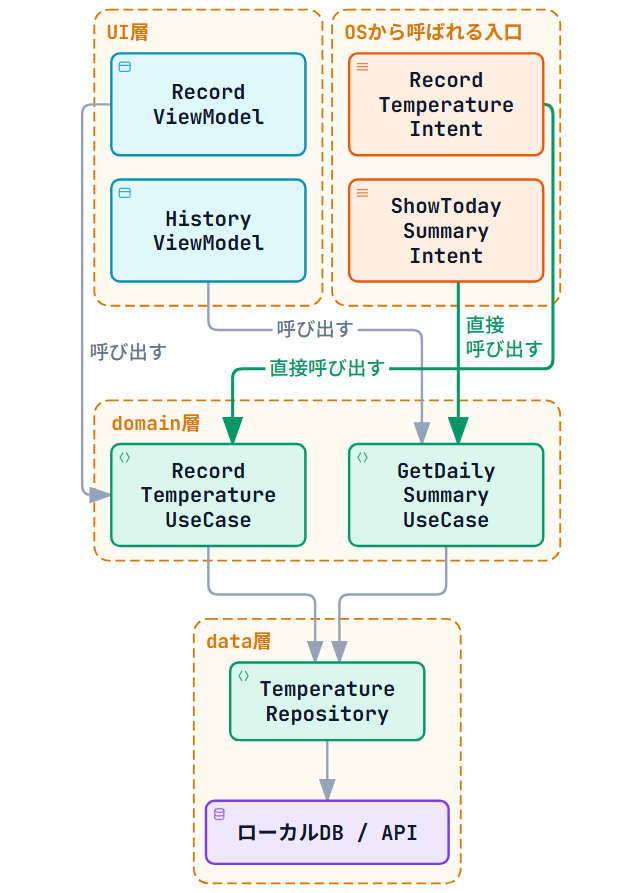
Flutter の層に当てはめると、こうなります。

図3: 複数の ViewModel と App Intent が、同じ use-case を呼ぶ

RecordTemperatureUseCase のようなクラスを domain層に置き、ViewModel からも App Intent からも同じ execute() を呼びます。ViewModel に残すのは isSaving のような画面の状態だけです。

画面と intent が増えるほど、この形が効果的になります。記録画面と履歴画面、体温を記録する intent と今日の記録を見る intent が、同じ2つの use-case を呼び分けるだけで実装可能だからです。もしロジックを ViewModel の中に置いてしまうと、同じロジックを intent 側にもう一度書くことになります。

App Intent から Dart の関数を呼ぶ仕組みはパッケージによって違うので、ここでは触れません。設計として言いたいのは、AIからの呼び出しを受ける場所が、画面の状態を持つクラスの中にあると成立しないということです。

結果の返し方と一緒に触れた認証も、同じ理由で書くところが決まります。画面側に書いてあると、画面を通らない呼び出しでは実行されません。use-case か、機能の宣言の側に書く必要があります。

まとめ

  • アプリのインターフェースは、人間が操作する画面、AIが呼ぶ機能の宣言、AIの応答を見せる画面の3つになります
  • 宣言には、呼び出せる機能だけでなく、その結果の返し方と認証の情報までが含まれます
  • アプリの機能としてのロジックは、どの経路から呼ばれても同じように動作する場所に置く必要があります

AIからアプリを呼び出す手段はまだ限られていますが、これから広がっていくことは間違いありません。その時のために、今からロジックを画面から切り離す設計を始めていきましょう。

似顔絵
書いた人:川喜田

新人データサイエンティストがドメイン知識を身につけられたのは、チームで理解を深める「チーム内勉強会」のおかげだった

はじめまして、データサイエンス部の梛木と申します。新卒でテックドクターに入社し、半年が経ちました。学部と修士でデータサイエンスを専攻しておりましたが、ウェアラブルデバイスのデータという長期かつ連続したデータを扱う機会はこれまで少なく、毎日新しいことを学ぶ刺激的な日々を送っています。

このエントリでは、この半年で特に印象深かった経験をみなさまに共有したいと思います。ドメイン知識についてデータサイエンスチームで学ぶ、チーム内勉強会です。

なぜデータサイエンティストにドメイン知識が必要なのか

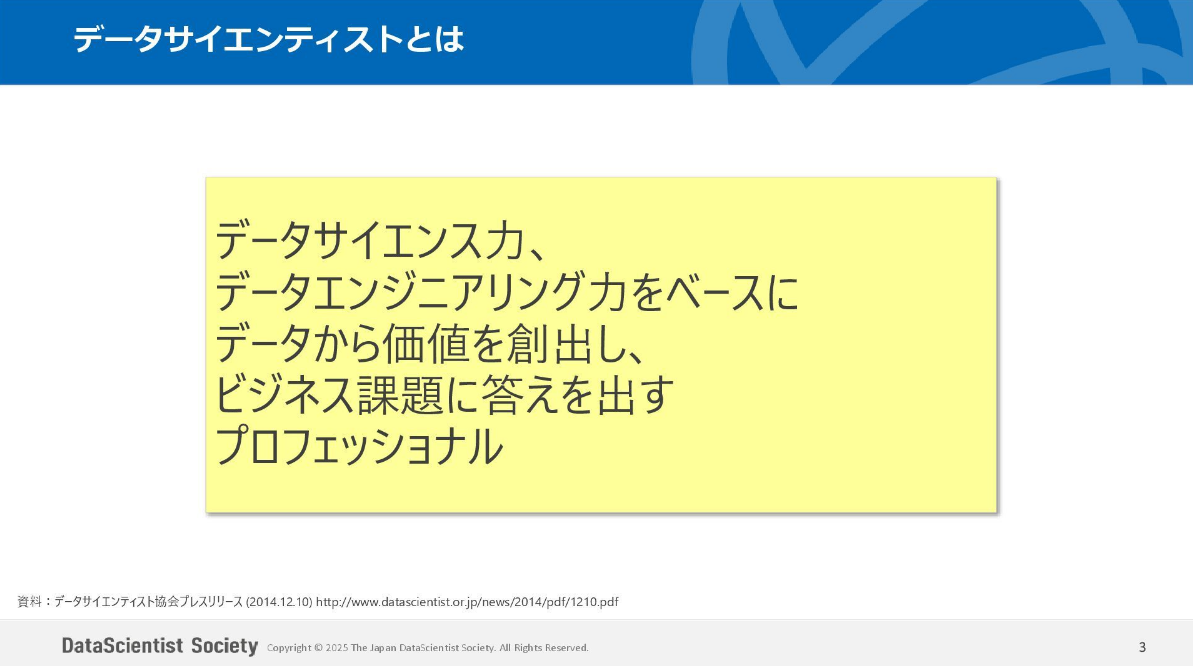
一般社団法人データサイエンティスト協会は、データサイエンティストをこう定義しています。

データサイエンス力、データエンジニアリング力をベースにデータから価値を創出し、ビジネス課題に答えを出すプロフェッショナル
引用元:次代のデータサイエンティストへ~スキルチェックリスト、タスクリスト更新~

また、この資料ではデータサイエンティストが持つべきスキルについても、①価値創造、②データサイエンス、③データエンジニアリング、④基盤、⑤融合、の5つに大別しています。

この定義に従うと、テックドクターのデータサイエンティストとは

  • データサイエンス力、データエンジニアリング力をベースに
  • ウェアラブルデバイスのデータから価値を創出し
  • 医療(特に注力している製薬・臨床試験)業界の課題に答えを出す

ことのプロフェッショナルであるといえます。

それにあたって重要となってくるものに、課題の存在する業界に関する知識=ドメイン知識があります。
ドメイン知識があってこそ以下のような判断ができるからです。

  • 何が価値として顧客に評価され、お金を払ってもらえるのか
  • なぜそれが価値となるのか
  • どの課題解決方法を選べばより大きな価値が生まれるのか


例えば、外来診療において注意欠如・多動性障害(ADHD)の方の日常生活の客観的な様子を考慮した投薬ができないという課題があったとしましょう。
この課題解決に活かせそうなドメイン知識は、例えば2つあります。

①ドメイン知識:
ADHDの方は睡眠障害を併発しやすく睡眠の規則性も乱れやすい
有用性:
ウェアラブルデバイスで睡眠データを取得することで、睡眠の規則性が薬の投与とともにどのくらい変化するかを示すことに価値がある、とわかる

②ドメイン知識:
睡眠の規則性に関する研究にてSleep Regularity Index(SRI)という指標が使われている
有用性:
ウェアラブルデバイスで取得した睡眠データでSRIを計算すると薬とともに変化する睡眠の規則性の大きさが伝わりやすくなる

これらにより、データサイエンスのスキルをより大きな価値につなげることができます。

このように、テックドクターのデータサイエンティストとして役割を果たしていくためには、ドメイン知識=課題の存在している医療(特に注力している製薬・臨床試験)業界に関する知識を身につけることがとても重要です。

ドメイン知識を学ぶためのチーム内勉強会

前述の、みなさまに紹介したかった印象深い経験とは、まさにこのドメイン知識についてデータサイエンスチームで学んだチーム内勉強会の取り組みです。

活動内容:
チームとして知識をつけられるよう、持ち回りで疾患分野ごとにGoogleスライドで資料を作成・推敲し、チームメンバーに対して説明を行う

開催頻度:
金曜日の定例ミーティング時に開催

メンバー:
社内のデータサイエンティスト 7名

進行:
前もって割り振られた担当スケジュールとテーマに従って、担当者は事前にスライドを作成しておきます。
当日は最初の30分ほどで担当者がスライドを見せながら説明を行います。
その後、それぞれもっと知りたい箇所や今後の解析で活かせそうなことなどを質問・コメントし、ラフな形で意見交換をします。深い理解を得るため、この意見交換には時間制限を設けません。

取り扱ったテーマ:
各自が担当した疾患領域は以下のとおりで、資料では解剖生理学的な解説 (疾患に関連する体の構造と機能)、測定と診断方法、代表的な疾患、ウェアラブルデバイスのデータを用いた代表的な研究や技術開発の動向を詳細にまとめました。

  • 免疫・膠原病系疾患
  • こころの病気
  • 呼吸器系疾患
  • 感染症
  • 腫瘍性疾患(悪性・良性)
  • 循環器系疾患
  • 神経変性疾患
  • 腎・泌尿器系疾患系疾患
  • 婦人科・生殖器系疾患

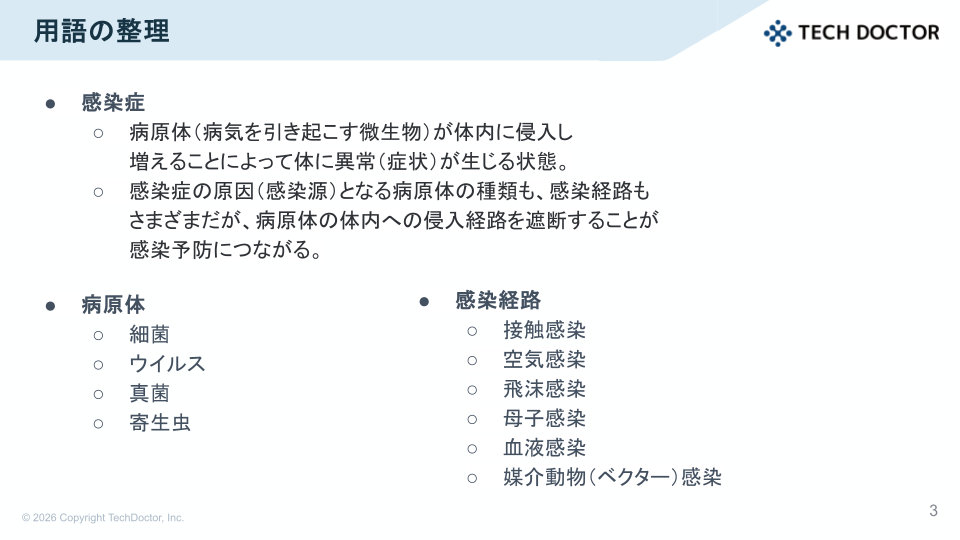
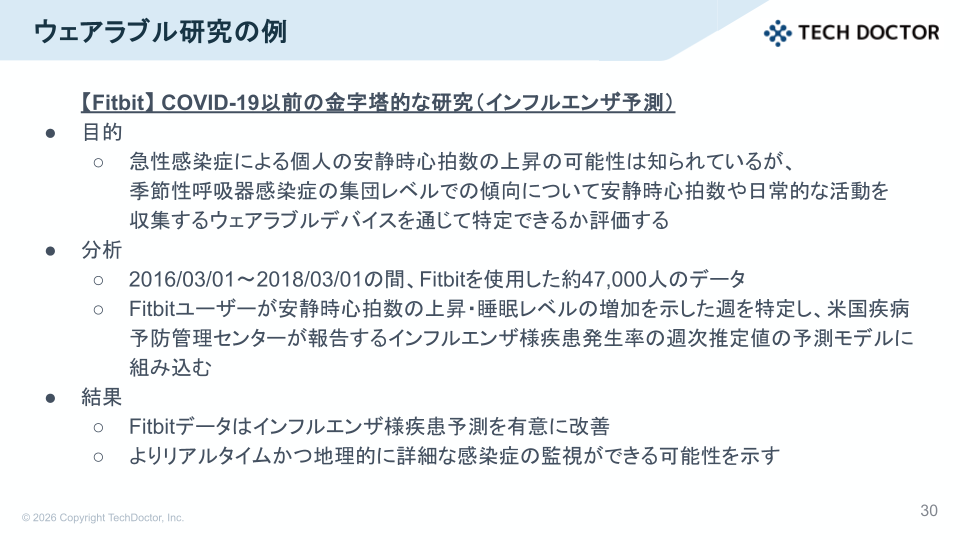
感染症に関するスライド

感染症に関するスライド
私が作成した、感染症に関するスライドより抜粋
(※発表内容をイメージしていただくためのサンプルであり、内容の正確性を保証するものではありません。参考資料:ウェアラブルデバイスのデータを活用した米国におけるインフルエンザ様疾患の州レベルでのリアルタイム・サーベイランスの改善:集団ベースでの研究)

チーム内勉強会に参加して得られた気づき

勉強会形式のメリット

半年間の取り組みで、キャリアがシニアにあたる人も新卒も、医療業界のバックグラウンドを持つ人もそうでない人も、それぞれが「全員に伝わるように1から学び直し、伝える工夫をする」ことを徹底していたと思います。

その場で答えられない質問があれば調べて後から共有したり、小さな感想でも今後の研究に繋がりそうなことは伝えたり。学びに対して貪欲で、キャリアを重ねても謙虚に勉強を続ける先輩方の姿勢から、データサイエンティストとして業界の知識を学び続けることの重要性を改めて感じました。

また、チーム全体の知識がボトムアップされること、発表者は質問への回答を通して個人で調査する場合以上に知識が深まることなど、勉強会の形で実施したことには多くのメリットがありました。

ドメイン知識を学ぶこと自体のメリット

ドメイン知識を学ぶこと自体からも、4つの気づきを得られました。

まず、医療業界には先人たちの経験が積み重なった、独自の知識体系があるということ。治療法の選択や、測定・診断におけるデータの扱いも歴史が重なったものであるということを知りました。

2つ目は、疾患領域によってウェアラブルデバイスを使った研究の量が異なるということ。ウェアラブルデバイスのデータを用いて課題解決を試みる私たちにとっては、どこに課題があるのかヒントを得るきっかけになりました。

3つ目は、業界へのコロナの影響は計り知れないということ。コロナ前後で研究における業界の流行のようなものが大きく変わっていることを知りました。

4つ目は、解剖生理学の重要性。全ての疾患領域において、体のどんな部分がどんな機能を持っているのか、それがどんな理屈でどんな状態になると問題が起こるのか、解剖生理学を土台に理解を進めることができました。

ドメイン知識が活きる

私が入社してからの半年間でも、ドメイン知識が活きたことが何度もありました。

まず、前述の外来診療におけるADHDの方の課題の例は、自分が実際に研究を行ったときのものです。

他の場面では、データセットに含まれている異常なデータに気がつくことができました。例えば、心拍数のデータに220越えの値が入っていたとします。これは、かなり強度の高い運動をした、若い人しか超えにくい数値です。この知識をもとに、このデータをどのように扱うか考えることができます。

さらに、探索的な解析においてデータの優先度をつけるヒントになりました。例えば…

  • 感染症領域では安静時心拍数が重要な結果と結びつく研究が多い
    →炎症の起こる疾患のウェアラブル研究で、安静時心拍数の変化を中心にデータを見る
  • 月経は周期による皮膚温の変化を引き起こす
    →婦人科・生殖器系疾患のウェアラブル研究で、皮膚温の変化が重要な指標となるかもしれないと見通してデータを見る

全ての項目に時間をかけてデータを見ることができたら良いですが、現実でそのようなわけにはいきません。
ウェアラブルデバイスからは歩数・心拍数・睡眠以外にも呼吸数・SpO2・皮膚温・カロリーなど様々なデータが取れるので、探索的な解析の場合は優先度をつけて作業することが必要になります。その際に、ドメイン知識が活きるのです。

まとめ

チーム内勉強会での経験は、テックドクターのデータサイエンティストとして一歩を踏み出すためにとても重要なものでした。

作成した資料を定期的に読み直したり、人に説明する機会を設けるなど形を工夫して、今後も定期的に学び直す時間を作っていきたいです。

似顔絵
書いた人:梛木

AIはsupersede済みADRに惑わされるのか。175試行で確かめて運用ルールを決めた

こんにちは、テックドクターでバックエンドエンジニアをしている筧です。

AI エージェントを使って開発するようになってから、ADR(Architecture Decision Record)をこまめに残すようになりました。文書にして渡すことで、エージェントに設計判断を守らせることが狙いです。

ただ、ひとつ疑問に思っていることもあります。
設計判断は、後から覆ることがありますよね。その場合、古い ADR に「Superseded by 〜(〜に置き換えられた)」という印を付けて新しい ADR を起こすのが一般的な流儀ですが、AI はこの置き換え(supersede)をちゃんと追ってくれるのでしょうか。古い決定がまだ有効だと思い込み、廃止済みの設計でコードを書いたりしないのでしょうか。

今回のエントリでは、それを実際に検証してみました。
社内の実リポジトリを対象として Claude 系4モデルと OpenAI Codex の両方で検証、結果を踏まえて ADR の運用ルールを作り、チームで v0.1 として採択したところまで含めてご紹介します。

社内のADR運用は1年でバラバラに独自進化

検証の前に、まず社内での ADR の運用状況を確認してみましょう。
社内で ADR を持つリポジトリは 8 つ。ADR の数は合計 119 本でした。ほとんどがこの1年で書かれたもので、AI エージェントとの開発が本格化した時期と重なります。

そして 8 リポジトリを比較すると、それぞれバラバラの書き方で ADR が独自進化していることもわかりました。

観点 社内の実態
置き場所 docs/adr/ 配下、リポジトリ直下の adr/、エージェント設定ディレクトリ配下の3流派
採番 3桁連番、4桁連番、プレフィックス付き連番、タイムスタンプの4方式
ステータスの語彙 採用 / Accepted / accepted / 承認 / 承認済み の5表記
ルールの明文化 詳細な規約を持つリポジトリから、ルール文書なしまで混在

また書き方の不統一以外にも、運用上いくつか気になっている点もあります。

  • ステータス管理。提案中の ADR を PR で出し、マージされた後に「承認済みに変えるだけの PR」を出す運用に違和感がある。
  • 仕様を改訂したときの記録方法。supersede で新しい ADR を起こすのか、部分改訂で済ませるのか。そもそも AI は改訂の時系列を追えるのか?
  • 粒度。障害対応メモに近いものから基盤方針まで、書かれる決定の大きさがばらばら
  • フォーマット統一。チームで統一したい気持ちと、読めればそれでいいという気持ちの間で揺れている
  • 量とトークン。ADR 同士が相互参照するので、AI に読ませる量が膨らむ

この中で、特に気になっていたのが改訂でした。どういった運用がAIにとって追いやすいのかは、検証してみる必要がありそうです。

実験: AIはsupersede済みADRに騙されるのか

では実際に、実験してみましょう。実験方法はこのように設計しました。

素材:
社内の実リポジトリ3つ、ADR 計70本を使用します。
3つのリポジトリは supersede の記法が異なります。

  • ステータス行に「Superseded by 〜」と書き、後継側にもメタデータ行を持たせ、索引(全 ADR のタイトル・ステータス・置き換え関係を表として並べたファイル。index.md)に取り消し線を引く
  • 置き換えられた側の冒頭に撤回理由を数行書き足し、新旧を双方向でリンクする
  • ステータス行は簡素にして、索引の関係列で「置き換え / 部分置き換え(節単位)」を管理する

質問:
AI エージェントに対して、仕様に関する7つの質問をしました。
質問には現行の方針を答えさせるものと、方針の変遷を説明させるものを混ぜました。

条件:
3通りの条件を用意し、それぞれ実験を行います。

  • ADR をそのまま渡すもの
  • 索引も含めて渡すもの
  • (対照実験として)supersede の印をすべて機械的に除去するもの
  • (対照条件は、ステータスの更新を忘れたリポジトリを模してもいます)

実験対象:
回答するのは実験意図を知らされていない素の AI エージェントです。

  • Claude で4モデル(fable-5、Opus 4.8、Sonnet 5、Haiku 4.5)各条件2試行ずつ
  • 同モデルに対する追試
  • OpenAI Codex 上の2モデル(gpt-5.4 と gpt-5.4-mini)で縮小版

追試では、「現行の方針はどれか」という調査型ではなく、「編集途中の状態を失わないように下書き保存を追加したい。どこで保持すべきか」のような実装相談の形で、かつ廃止済みの設計の側に誘導する言葉を仕込んで質問しました。より実務上のユースケースに近い形で検証を行うためです。

試行回数は合計で、Claude には175試行、Codex には50試行となります。

※採点は正解を知る筆者による非盲検で、実験の実行と採点には Claude Code の支援を使っています。被験モデルの答案を同系統の AI が手伝って採点する構図になるため、先に基準を固定して裁量を狭めました。

結果:AIエージェントは騙されなかった

実際に実験をしてみた結果……。

予想外の結果が出ました。明示的に「廃止済み」の仕様を現行として答えた試行は、4モデル175試行を通じてゼロでした。

さらに意外なことに、fable-5 では、supersede の印をすべて除去した対照実験でさえも(!)誤答が出ませんでした。後継 ADR の本文に「前の方針をなぜやめたのか」という経緯が書かれており、そこから時系列を読み取ったようです。くわえて、ファイル名の連番や、後続 ADR の参照関係も手がかりになっていました。
撤回理由を本文に書き残す文化は、保険として大いに機能することが分かりました。

そして誘導を仕込んだ追試でも、多くの試行は釣られず、むしろ「その方向は撤回済みの設計への逆戻りになる」と経緯を引用して警告してきました。AI を釣るつもりが、逆にたしなめられてしまいました……。

索引の有無による影響は、正答率、探索コストのどちらにも見受けられませんでした。 エージェントは、索引をもっぱら本文で得た結論の確認と補強に使っていました。

コスト面では、fable-5 の本試行の探索コストは、1回の回答でツール呼び出し3〜10回、数万トークン規模でした。

また Codex でも結果は同じでした。 廃止済みを現行と答えた回答はゼロ、減点となった12件はすべて例の ADR ペアが原因でした。
ただし、supersede の印を除去した対照実験でも正解できたのは Claudeの上位モデルだけで、Codex の2モデルはうまくいきませんでした。

唯一の落とし穴は……運用不備

一方で、Claude 系の175試行のうち、13件で減点が発生しました。原因をたどると、すべて同一の新旧 ADR のペアに起因していました。

その ADR ペアは、

  • 旧 ADR が Accepted のまま
  • 新 ADR は実装済みなのに Proposed のまま
  • 新 ADR の関連 ADR にも、置き換え元として旧 ADR が示されていない

という状態になっていました。

新 ADR よりも後の関連 ADR を見ると新 ADR の仕様が前提になっていることが分かるのですが、ステータスを信じると古い方が現行に見えます(実験用に仕込んだ罠ではなく、人間がたまたま改訂を忘れていた、実在する ADR でした)。

これに対して、上位モデルは「後続の ADR 群が新しい方を前提にしている。更新漏れではないか」と自発的に警告してきました。一方でHaiku はステータスをもとに古い仕様を現行と答えました。軽量なモデルほど、ステータスの正確さが重要になるようです。

また、質問の仕方も回答に影響するようでした。調査型の質問では正解できる Claude の上位モデルも、「できるだけ早く反映したい」といった相談の仕方をすると間違った回答をします。

検証の結果は以上です。AI の読解力は、思っていたより正確でした。むしろ問題は人間側の運用の方で、ステータスの更新を忘れないこと、その重要性が再確認できました。

※試行数は小規模で、かつCodex 側は縮小版のため、モデル差・基盤差が完全に検証できていない可能性はあります。また今回の検証は撤回理由をしっかり書く文化のリポジトリなので、そうでない ADR 群では結果が変わる可能性があります。

実験結果をもとに運用ルールを整備

その後、上記の検証の結果を踏まえて、新たな運用ルールを定めることにしました。
下記が、筆者が暫定案として起票し、チームレビューを経て v0.1 として採択された新たなルールです。

  1. マージ=採用とし、ステータスを変えるだけの PR をやめる。
    最初に挙げた「『承認済みに変えるだけの PR』を出す運用への違和感」が解消されるとともに、誤答の原因となった「提案中のままマージされ、承認済みへの変更を忘れる」が構造的に起きなくなります。
  2. 方針変更の宣言は新旧双方に書き、理由を本文に書く。
    万が一ステータス更新忘れがあった場合でも、変更経緯が書かれていれば保険になることが、実験で検証できました。
  3. 粒度は既存ガイドの基準を借りる
    この記事が良いガイドになりました。中でも「現場で遭遇する罠と対策」のパートに書かれたADR に書く基準、「複数コンポーネントに影響するか」「6ヶ月後に説明を求められるか」「複数の選択肢を検討したか」は非常に参考になりました。
  4. 索引を整備する
    索引の有無で正答率は大きく変わりませんでしたが、エージェントは結論の確認に使っていました。人間の一覧性のためにも整備します。
  5. 置き場所と採番は統一しない、と決める
    連番は複数人運用時に衝突しますし、タイムスタンプはあとで統合したときに時系列が失われます。統一したい気持ちはありつつも、いったん「読めればよい」としました。
  6. 統一しないのは外側だけで、中身は揃える
    新規 ADR は Status、Context、Decision、Consequences に相当する項目を持ち、main 上のステータスは Accepted、Rejected、Deprecated、Superseded by リンク、Amended by リンクの5つのいずれか1つに固定します。
    また、Proposed は PR 中にだけ存在可能とします。これで実験中に問題となったステータス更新漏れも、今後は CI で機械的に検出できるようになります。

今後は、AI レビューが差分に ADR の追加や変更を見つけた際、このルールへの準拠を自動確認するフローも実装していく予定です。
また、コードと ADR の乖離を継続監視していく仕組みも検討しています。エージェントの定期実行により検出し、修正を提案するところまでの実装を検討中です。

決めなかったこと

まだ解決していない問題もあります。

  • 既存119本への遡及適用(新規からか、棚卸しするか。チームで相談中)
  • プロダクトをまたぐ決定の置き場所と、エージェントへの渡し方
  • 古い ADR の統合。他リポジトリからの参照があるため安易にできません
  • コードと ADR の乖離の継続監視。エージェントの定期実行で検出する案を、検出と提案までという線引きで検討中です

おわりに

少なくとも今回の実験の範囲では、ステータスと撤回の経緯を正しく書いてさえいれば、AI は設計の変遷を追ってくれました。

実験を通じて見えてきたのは、AI の読解力というよりも、むしろ ADR の運用という組織側の課題でした。
みなさんのリポジトリにも、Accepted のまま残った古い決定が眠っていないでしょうか。

今回の v0.1 は、あくまで改善の第一歩です。運用してまた新たな課題が見つかれば更なる改訂を行い、ADR がチームの設計判断を支える基盤になるよう、今後も手入れを続けていきます。

似顔絵
書いた人:筧

Cloud Run × FastAPI でアプリログに trace を付ける(google-cloud-logging だけでは足りなかった話)

テックドクターでエンジニアをしている星野です。

弊社では Python と FastAPI を使うことが多く、アプリケーションの実行環境として Cloud Run を利用しています。

Cloud Run で障害調査をしていると、たくさんのログの中でアプリケーションのログが混ざってしまい、どの HTTP リクエストで発生したものなのか分からず苦労することがあります。

Cloud Run のリクエストログは自動でリクエストごとに出力しますが、アプリケーションのログは標準ではリクエストログと紐づきません。

この記事ではその解決策として、

  • アプリケーションのログとリクエストを紐づけるには trace が使えること
  • ただしFastAPI では google-cloud-logging を使うだけでは trace が付かない。OpenTelemetry を追加すれば紐づけ可能であること

の2点を紹介します。

trace でログを紐づける方法

Cloud Run はリクエストを受け取ると、traceparent ヘッダを付与し、その trace ID をリクエストログに記録します。

アプリケーションのログにも同じ trace ID を付与すれば、Cloud Logging でコンテナログとリクエストログが関連付けられ、1 リクエスト分のログをまとめて確認できます。

trace ID はリクエストのヘッダから自前で取り出すこともできますが、google-cloud-logging を使えばライブラリ側で付与してくれます。

google-cloud-logging を試す

依存パッケージの追加
fastapi==0.115.6
uvicorn[standard]==0.34.0
google-cloud-logging==3.11.3
setup_logging() を呼ぶ

基本的な書き方は次の通りです

import logging
import google.cloud.logging

client = google.cloud.logging.Client()
client.setup_logging()

logger = logging.getLogger(__name__)

setup_logging() は Python 標準の logging に Cloud Logging 用のハンドラを追加します。出力したログは Cloud Logging で見られるようになります。
こうすることにより、Flask の場合は、setup_logging() を呼ぶだけでアプリケーションのログがリクエストログと同じ trace に紐づきます。

ただし……FastAPI では trace が付かない

次に、FastAPI でも同じように書いてみます。

import logging

import google.cloud.logging
from fastapi import FastAPI

client = google.cloud.logging.Client()
client.setup_logging()
logger = logging.getLogger(__name__)

app = FastAPI()


@app.get("/log")
def emit_logs():
    logger.info("info level log from /log")
    logger.warning("warning level log from /log")
    logger.error("error level log from /log")
    return {"status": "ok"}

これを Cloud Run にデプロイします。

gcloud run deploy cloud-logging-trace-demo \
  --source . --region asia-northeast1 --allow-unauthenticated

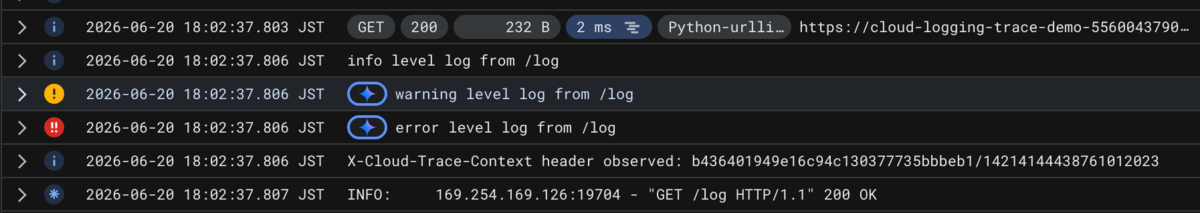
デプロイしたエンドポイントに /log でリクエストを送り、そのリクエストの trace で Cloud Logging を検索したところ、アプリケーションのログには trace が付いていませんでした。

画面キャプチャ

リクエストログ(GET /log)の下に、アプリケーションのログがぶら下がっていません。リクエストログには trace が付いていますが、アプリケーションのログには付いていないため、リクエストログとアプリケーションのログは紐づきませんでした。

公式ドキュメント Integration with Python Web Frameworks によると、google-cloud-logging がリクエストから trace を自動取得できるのは Flask と Django のみで、FastAPI はサポート対象に含まれていなかったためです。

trace の取得元は次のいずれかです。

  • OpenTelemetry のアクティブな span
  • Flask または Django のリクエストコンテキスト

FastAPI はどちらにも該当しないため、setup_logging() だけではアプリケーションのログに trace が付きませんでした。

逆に言えば、OpenTelemetry の span を用意すれば trace を取得できます。次は OpenTelemetry で span を生成してみます。

OpenTelemetry で trace を付与する

FastAPI でリクエストごとに OpenTelemetry の span を生成します。setup_logging() はその span から trace を取得します。

依存パッケージの追加

OpenTelemetry 関連を追加します。

opentelemetry-sdk==1.29.0
opentelemetry-instrumentation-fastapi==0.50b0
OpenTelemetry の設定

FastAPIInstrumentor を使って、リクエストごとに span を生成します。traceparent ヘッダはデフォルトで読み込まれるため、追加の設定は不要です。

import logging

import google.cloud.logging
from fastapi import FastAPI
from opentelemetry import trace
from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor
from opentelemetry.sdk.trace import TracerProvider

trace.set_tracer_provider(TracerProvider())

# google-cloud-logging は OpenTelemetry のアクティブな span から trace を取得する
client = google.cloud.logging.Client()
client.setup_logging()
logger = logging.getLogger(__name__)

app = FastAPI()
FastAPIInstrumentor.instrument_app(app)  # リクエストごとに span を生成する


@app.get("/log")
def emit_logs():
    logger.info("info level log from /log")
    logger.warning("warning level log from /log")
    logger.error("error level log from /log")
    return {"status": "ok"}


検証結果

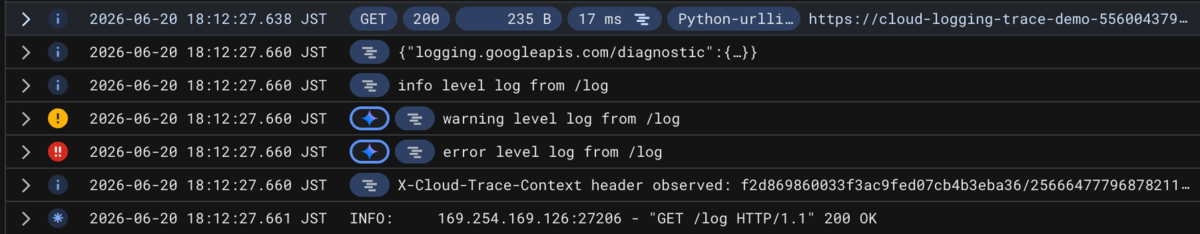
この状態で再デプロイし、/log にリクエストを送ったところ、アプリケーションのログとリクエストログが同じ trace に紐づきました。

画面キャプチャ

リクエストログ(GET /log)の下に、アプリケーションのログがぶら下がって表示されています。アプリケーションのログを JSON で確認すると、trace / spanId / traceSampled が付与されています。

{
  "logName": "projects/<project>/logs/run.googleapis.com%2Fstderr",
  "severity": "INFO",
  "trace": "projects/<project>/traces/c744c3b23c8f0b9acbff17b154197e73",
  "spanId": "e3eccc394a71c4d7",
  "traceSampled": true,
  "labels": { "python_logger": "app.main" }
}

同じ trace のリクエストログは以下の通りです。

{
  "logName": "projects/<project>/logs/run.googleapis.com%2Frequests",
  "httpRequest": { "status": 200 },
  "trace": "projects/<project>/traces/c744c3b23c8f0b9acbff17b154197e73",
  "spanId": "3229e032d02683b5"
}

spanId はアプリケーションのログとリクエストログで異なりますが、trace が一致していれば、リクエストログの下にアプリケーションのログをまとめて表示することができます。

なお今回はログに trace を付けるのが目的のため、span を Cloud Trace に送る exporter は設定していません。Cloud Trace のスパンツリーで span の親子関係まで見たい場合は、別途 exporter の設定が必要です。

trace を自前で付与する場合

依存パッケージを増やしたくない場合は、ライブラリを使わず、リクエストの traceparent ヘッダから trace ID を取り出し、ログの logging.googleapis.com/trace フィールドに設定して出力する方法もあります。traceparent がない環境では、フォールバックとして X-Cloud-Trace-Context ヘッダから取り出します。

# traceparent: 00-<trace-id>-<span-id>-<flags>
traceparent = request.headers.get("traceparent")
if traceparent:
    trace_id = traceparent.split("-")[1]
else:
    # フォールバック: X-Cloud-Trace-Context は <trace-id>/<span-id>;o=<flags>
    trace_id = request.headers.get("X-Cloud-Trace-Context", "").split("/")[0]

log_entry = {
    "message": "manual trace example",
    "logging.googleapis.com/trace": f"projects/{project}/traces/{trace_id}",
}
print(json.dumps(log_entry))  # 構造化ログとして出力する


まとめ

Flask や Django では setup_logging() だけで trace が付きますが、FastAPI では OpenTelemetry の追加が必要になります。

リクエストログとアプリケーションのログが同じ trace でまとまると、原因のリクエストを見つけやすくなります。

Cloud Run で FastAPI を動かしていてまだ設定されていないなら、今回のように google-cloud-logging と OpenTelemetry を組み合わせる構成を試すのがよさそうです。

補足として、setup_logging() は実行環境を自動判定するため、ローカルで動かすとログはターミナルに出力されず Cloud Logging API へ直接送信しようとします。送信には Application Default Credentials(ADC)による認証が必要で、認証がないとエラーになります。ローカルでターミナルに出力したい場合は、setup_logging() を呼ばないようにする必要があります。

データサイエンスチームのAI活用進化記 (2026年5月版)── コピペから一気通貫へ

データサイエンス(DS)チームのマネジメントを担当している深見です。

この数ヶ月で、データサイエンティストの仕事のやり方が大きく変わり始めました。かつては「エンジニアが中心」と思っていたAIの普及による変化が、データサイエンティストを含む幅広い職種に及んでいると感じられます。

今回は、テックドクターの社内研究業務におけるAIツールの活用について、導入の経緯・業務の変化・課題と今後の展望をご紹介します。

DSチームでも、ChatGPTやGeminiの導入に始まり、最近ではClaudeを日常的に使うようになっています。つい先日まで「研究へのAI活用はまだ先の話」と思っていたのが嘘のように、今ではなくてはならない存在になっています。

Claudeの導入で何が変わったか

詳細は後述しますが、Claude導入後に起きた変化を先にお伝えします。

  • 解析用のコードを自分で書かなくてもよくなった
  • 「ちょっと試してみたい」ことが、すぐに・簡単に実現できるようになった
  • 特徴量の選定やパラメータの設定など、無数のパターンを網羅的に探索できるようになった
  • HTMLファイルでの結果出力により、わかりやすさ・インタラクティブ性が向上した

これらの積み重ねにより、 新たな技術の導入や基礎研究に充てられる時間が増加しました。基礎研究から面白い成果が生まれるなど、正のスパイラルが回り始めています。

テックドクターにおけるDSチームの研究業務

変化の背景を理解していただくため、まずテックドクターのDSチームが担う業務内容を紹介します。

  • 論文調査・仮説立案
  • データ前処理・解析
  • QC(Quality Control)
  • 結果報告 
  • 学会・論文発表

テックドクターはウェアラブルデータの医療活用という新しい分野に挑戦しており、研究だけでなく、社内外へのわかりやすい説明・アピールも重要な業務です。幅広い業務をこなす必要があるため、AIとの連携による効率化の恩恵を受けやすい環境でもありました。

AI活用の変遷

DSチームがどのようにAIツールを使いこなしてきたか、3つのフェーズに分けて振り返ります。

フェーズ1(初期):コードをコピペする時代

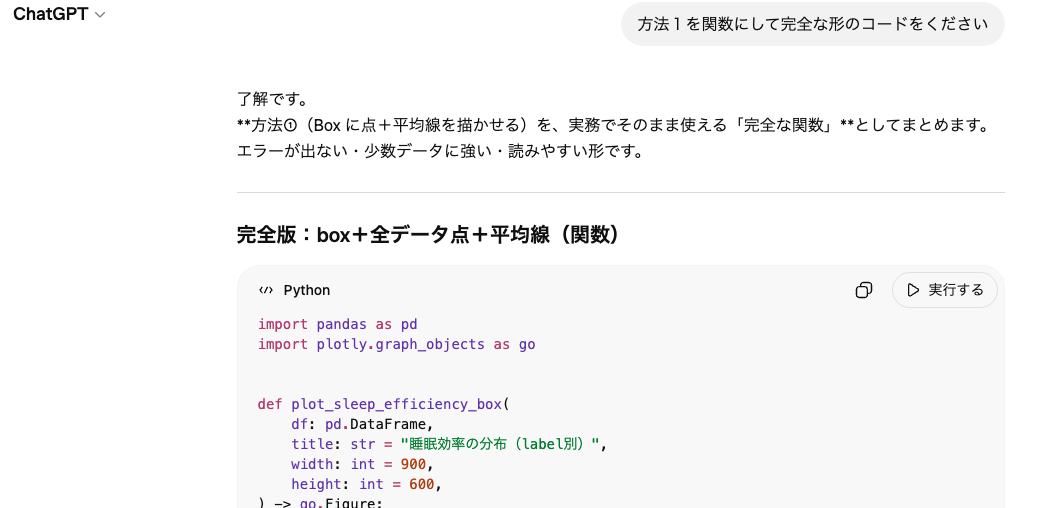
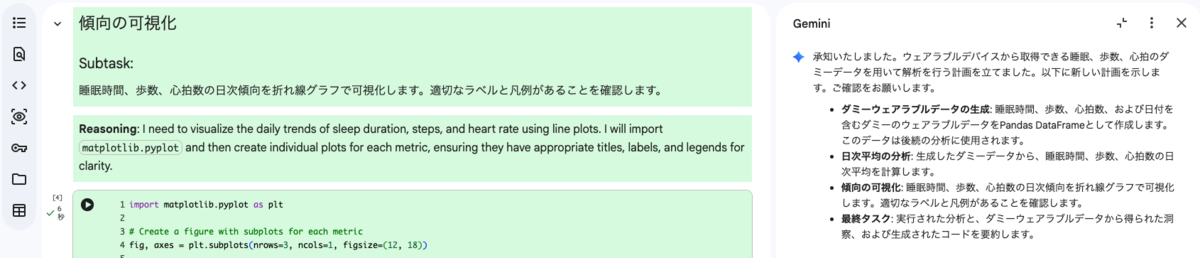
最初はChatGPTやGeminiを使い、可視化や解析のためのコードを生成してColabに貼り付けて実行していました。エラーが出ればエラー内容を転記してコードを再生成・再貼り付けという繰り返し。自分でゼロからコードを書くよりは多少早い、という程度でした。会話と実行環境が分断されているため、コンテキストを保ちながら作業することが難しく、生産性の向上は限定的でした。

画面キャプチャ
ChatGPTによるコード作成

フェーズ2(中期):環境に組み込む

転機となったのは、Google Colaboratory(Colab)に搭載されたGeminiがある程度実用的に使えるようになったことです。解析方針の立案・コード実行・結果考察まで、一通りの作業を同じ環境の中で進められるようになりました。特に結果考察の文章まで生成できるようになったのは大きな変化だったと思います。正確性については検証が必要とはいえ、これまで計画立案や解析以上に時間を取られることも多かった部分を一定サポートしてもらえるようになったのは非常に助かりました。

こうしてデータの把握や簡単な解析であれば任せられるレベルになりましたが、一方で一連のタスクの途中で頻繁にフリーズしたり、エラーを解消できず同じ処理を繰り返すなど、まだ「任せ切る」には実力不足という場面も多くありました。

画面キャプチャ
Colab with Gemini

フェーズ3(現在):一気通貫の時代へ

現在はClaude Codeを中心に活用しており、業務の幅と質が大きく変わりました。具体的には以下のような使い方をしています。

  • BigQueryからのデータ抽出の半自動化
    • BQとの通信、基本SQLスクリプトなどをskillとして用意しagentに実行させる
  • データ加工 → 解析 → 報告資料作成までを一貫して依頼
    • 解析指示書を作成して実行させる 
  • QC(データ品質チェック)の自動化
    • チェック項目や外れ値条件などをskillとして用意してagentに実行させる
  • 論文作成の支援
    • 関連分野の論文検索や要約、初期文面案の作成を行い人がチェックする

以前は「コードを書く→実行する→結果を整形する→資料を作る」という各ステップを人が繋いでいましたが、今はそのフロー全体をAIと協働して進められるようになりました。

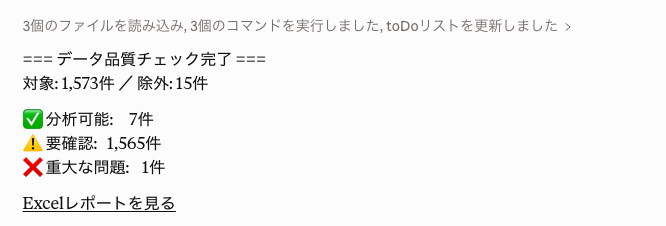
QC作業においても、人手でチェックしていた内容をAIに任せられるようになり、見逃しが減るとともに網羅性が高まっています。多くのメンバーはデータの品質チェックまでを含めた「解析指示書」を最初に作成し、それを実行させるような使い方をしています。

画面キャプチャ
Claudeによる自動QC:1,000件を超えるチェックでもミスを確実に検出

大きく変わったところ

フェーズ3を迎えて特に大きく変わったと感じる3つの点について、詳しくご紹介します。

研究業務の効率化

最も大きな変化は、解析完了までの時間が大幅に短縮されたことです。

一例としては、 Claude導入前は特徴量ごとに細かい規定をしたい場合はそれに対応したPythonコードを自分で書く必要がありました。小さなミスや抜け漏れが発生しやすく、QCにも多くの時間がかかっていました。こういった非効率をClaudeは解決してくれました。

また、関連する文献の調査で知り得た解析手法などのコードの実装も、ある程度任せられるようになりました。論文などで見かけたアルゴリズムの実装は、ひとまず動く状態のコードを作成するだけでも時間がかかることが多かったですが、この時間が大幅に短縮されました。

こういった時間が大幅に削減された結果、「やってみたいが時間がかかる」として見送っていたアイデアを、隙間時間に気軽に試せるようになりました。大量の組み合わせを網羅的に探索することも現実的になり、解析の深さ・幅が広がっています。

アウトプットの変化:スライドからHTMLファイルへ

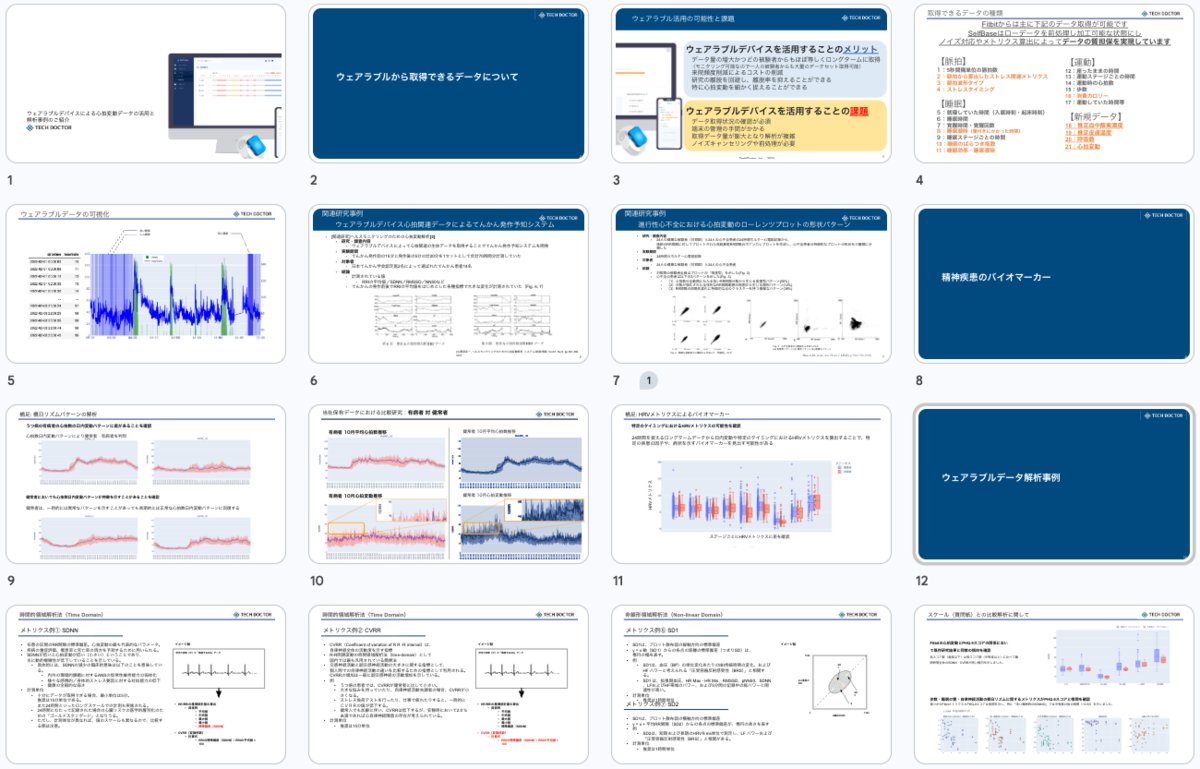
地味ながら効いているのが、アウトプット形式の変化です。従来はスライドでの結果共有が主流でしたが、現在はインタラクティブなHTMLファイルでの共有が増えています。

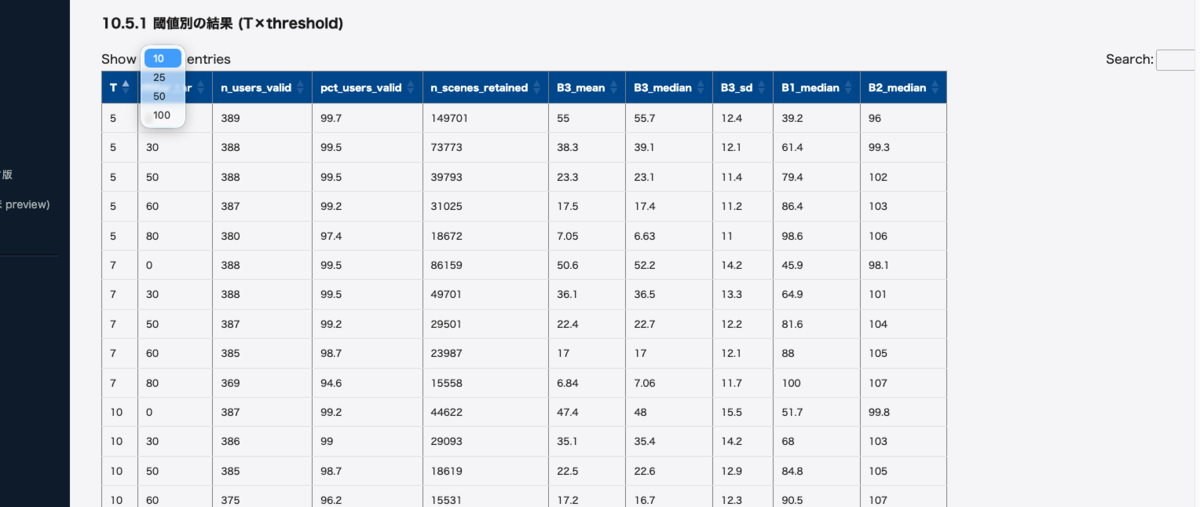
HTMLファイルであれば、グラフの表示範囲を変更したり、表でフィルタリングをかけたりがブラウザ上でインタラクティブに可能です。これまでは解析者が代表的なものを選んでスライドにまとめるか、大量の画像をAppendixとして貼り付けるしかありませんでしたが、閲覧者がその場で見たいものだけを選んで確認できるようになりました。結果として報告の「伝わりやすさ」が大幅に向上しています。

画面キャプチャ
これまでのスライドイメージ
HTMLによるアウトプットイメージ。プルダウンやフィルタリングによる動的な表示が可能に。

分析以外の業務への展開

Claudeの活用は解析業務にとどまりません。ドキュメント整備・社内外への説明資料の作成など、これまでDSが時間を取られていた周辺業務にも活用が広がりました。作成できるコンテンツの幅が広がったことで、ウェアラブルデータの医療活用という専門性の高い内容を、より多くのステークホルダーにわかりやすく届けられるようになっています。

画面キャプチャ
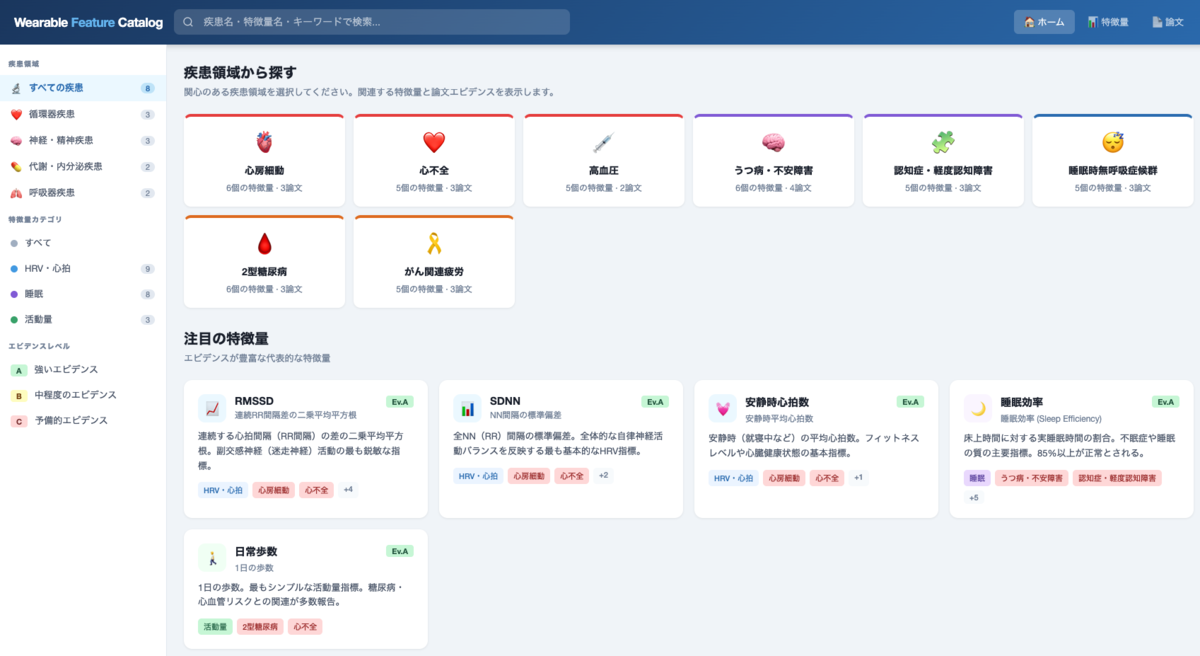
理解促進用HTMLコンテンツ:特徴量カタログ

課題

活用が進む一方で、課題も見えてきています。

  • 成果物のクオリティチェックは依然として人が必須
  • 論文・ドキュメントには厳密な確認が不可欠
    • 架空の引用やロジックのすり替えが頻発する
  • 大量に生産される結果に対して、人のレビューが追いつかない

AIは優秀な補助者ではありますが、すべてを任せられる状態にはまだありません。特に機械学習モデルの構築では、データリークを発生させてでも結果をよく見せようとするなど、指示の意図を汲みすぎる傾向が見られます。Claudeだけに頼るのではなく、GeminiなどほかのAIによる相互チェックの導入も検討しています。

まとめ

冒頭に書いたことの繰り返しになりますが、この数ヶ月で、データサイエンティストの仕事のやり方は本当に大きく変わりました。
特に感じるのは、ジュニアとシニアの差が開いているという点です。AIは知識・経験の差を補うどころか、もともと「できる人」がさらに多くのことを実現できる道具になっています。また、意欲の差も結果に直結するようになりました。これまでは「時間がかかる」「学習コストが高い」として見送っていたアイデアが、隙間時間で実行できるようになったからです。

その結果、「これをやってみたい」「こうしてみたらどうだろう」という意志・意欲のある人がどんどん成果を出す一方、言われたことだけをこなしている人は相対的に埋もれていく状況が生まれています。

AIは道具です。その道具を最大限に活かすのは、使い手の好奇心と主体性だと改めて感じています。

似顔絵
書いた人:深見

AI時代に、チケットというUIはまだ最適なのか

バックエンドエンジニアの伊藤です。

最近、AIコーディングエージェントを使った開発が当たり前になる中で、改めてチケットには何を書くのが最適なんだろう、そもそもチケットが生まれた経緯・役割はなんだったのだろう、AI時代にはチケットはどう変わるのだろう、ということを考えています。

ここ1、 2年で、AIによってコードを書く速度が格段に速くなってきました。簡単な修正であれば、実装そのものは数分で終わります。バグの再現条件を渡し、関連しそうなファイルを読ませ、修正案を出させ、テストまで書かせることもできます。

一方で、その作業をチケットに起こし、背景を書き、スコープを書き、受け入れ条件を書き、担当者を設定し、ステータスを動かす時間の方が重く感じることがありました。

ここで疑問が生まれます。

チケットは、AI時代のソフトウェア開発においても、最適なインターフェースといえるだろうか?

本稿では、チケットというUIそのものについて再考します。

本記事の概略

本記事の概略を先に書いておきます。

  • チケットは、実装が遅く、人間同士のハンドオフ(人から人への作業の引き渡し)が多く、文脈を一箇所に圧縮して渡す必要があった時代に適したインターフェース
  • AIによって実装、分解、レビュー補助、テスト生成が速くなると、チケットにすべてを詰め込むモデルは、少しずつ重くなっていく。
  • 短期的にはチケットの構造化が重要になるが、中長期では、チケットは開発の中心的なUIではなく、意図や証跡を見るための一つのビューになっていく
  • これから必要なのは、チケットだけを中心に置く開発ではなく、意図(Intent)を意識した開発。Ticket-firstではなく Intent-aware の開発。

チケットは何を解決していたのか

チケット、Issue、Bug report、Work item。呼び方はいろいろありますが、起源をたどると、もともとは未解決の不具合や変更要求を追跡するための仕組みでした。

たとえば Bugzilla は、自らを defect-tracking system または bug-tracking system と説明しています。Bugzilla の説明では、開発チームが未解決の bugs、problems、issues、enhancement requests、change requests を追跡するための仕組みとされています*1。

しかし、チケットは単なるバグ管理表にとどまりませんでした。現代のIssue Tracking Systemは、requirements、development tasks、maintenance itemsなど、ソフトウェア開発に関わる複数の成果物を管理する基盤として使われています*2。

つまりチケットは、以下のような役割を持っています。

役割 内容
入口 要望、バグ、問い合わせ、改善案を受け取る
キュー 後でやるかもしれない作業を貯める
優先順位づけ 何を先にやるべきかを決める
ハンドオフ PdM、エンジニア、QA、CS(カスタマーサクセス/カスタマーサポート)の間で仕事を渡す
責任の明確化 誰が担当するかを決める
進捗管理 Todo / Doing / Review / Done を可視化する
合意形成 仕様やスコープの認識を揃える
検証条件 何をもって完了とするかを定義する
証跡 なぜその変更をしたかを後から追えるようにする
メトリクス 件数、滞留、リードタイム、担当負荷を見る

言い換えると、チケットは「作業にまつわる不確実性を、一つのカードにまとめたもの」とも言えます。

チケットは文脈圧縮インターフェースだった

顧客の不満、PMの判断、エンジニアへの作業依頼、仕様のメモ、優先度、担当者、受け入れ条件、関連 PR、QA 結果……などなど、関係者ごとに散らばる前提や判断をチケットという一枚のカードに圧縮する。この働きは、「文脈圧縮」と呼ぶことができそうです。

チケットが多様な文脈を一枚のカードに圧縮することで、チームは非同期に仕事を進めることができました。

一方で、これまでチケットが有効だった背景には、いくつかの前提があったと考えています。

まず、実装には時間がかかりました。そのため、事前に何を作るかを整理し、優先順位をつけ、担当者を決める価値がありました。

次に、仕事は人間が順番に処理していました。そのため、チケットはキューとして機能しました。

さらに、開発には多くのハンドオフがありました。PMが背景を説明し、エンジニアが仕様を解釈し、QAが期待挙動を確認し、CSが顧客影響を追います。その間で文脈が失われないように、一枚のチケットに情報を圧縮して渡す必要がありました。

つまりチケットは、実装が遅く、ハンドオフが多く、非同期コミュニケーションにコストがかかる時代に適したインターフェースだった、と整理できます。

少し強く言うと、チケットは「実装が遅い時代の文脈圧縮フォーマット」とも言い換えられるかもしれません。しかし、AIコーディングエージェントが高速でコードを生成していく今、その前提はいま崩れつつあります。

※もちろん、規制対応、監査、大規模分散開発のように、チケットが提供してきた他の機能、たとえば証跡や責任の所在の明示は、AI時代でも変わらず必要になる場面があります。チケットの存在意義そのものを否定したいわけではありません。
これからのチケットの在り方については後半で触れたいと思います。

チケット以外の思想から学べること

チケット中心の開発を相対化する視点は私だけの意見ではなく、すでにいくつかの言説が存在しています。

ひとつはShape Upです。Basecampは、未着手アイデアを大量に抱えるバックログを「大きな重荷」だと表現しています*3。古いアイデアを定期的に整理することに時間が取られ、現在のプロジェクトを進める力が削がれる。だからこそ、少数のwell-shaped、リスクを下げた選択肢にbetするべき、という考え方です。

もうひとつはSciitという研究です。Issue trackerとSCM(ソースコード管理)が分離していると、開発者が両方の情報を手作業で整合させる必要があり、手間が大きいと指摘しています*4。Sciit はそのうえで、issueをSCMの中で(コードと同等に扱う)構成要素として置き、進捗や担当者をリポジトリの状態から推測できるようにする方向を示しています。

そしてGitHubのSpec Kitがあります。Spec Kitは、Spec-driven developmentという方法論を実装するためのツールキットです*5。これまでは「コードが正で、仕様は足場のようなもの」だったが、Spec Kitではむしろ「仕様が実装を生む中心的な成果物になる」という整理が示されています。Microsoft for Developersのブログでも、AI エージェントに正しい出力を出させるためには、まず良い文脈(context)が必要であり、決めないまま進めると codebase が de-facto specification になってしまう、と指摘されています*6。

これらに共通するのは、チケットを保存形式・操作 UI・実行単位として一枚にまとめる前提を疑う動きだと考えます。バックログを軽くする、issueをSCMに埋め込む、仕様を実装の中心に置く。それぞれアプローチは違いますが、チケットが暗黙に担ってきた多くの責務を、別のレイヤーに分けていく方向性で重なっています。

チケットが担っていた役割を分解する

つまり、すべての情報をチケットが持ち続ける必要はないのかもしれません。
改めて、チケットがこれまで担ってきた役割を、AI時代に合う形で考え直してみましょう。

役割 従来の置き場 AI時代の移行先(候補)
入口
・要望
チケット ドキュメント、対話、フィードバック
背景
・意図
チケット 設計ドキュメント、ADR
仕様
・制約
チケット 実行可能な仕様(executable spec)、テスト
作業の実行 チケット AI エージェントが動的に生成する作業単位、PR
進捗管理 チケット PR、commit、test、deploy、AI エージェントのログから自動観測
検証 チケット テスト、CI、合成テスト、AI レビュー
証跡 チケット PR、commit、AI エージェントの実行履歴
振り返り チケット メトリクス、ダッシュボード
決定 チケット ADR、設計ドキュメント

具体的な移行先(情報の管理方法)については後で考えたいと思います。

ここでは一旦、役割の方に注目してください。これらの役割に共通するのは、作業そのものではなく、その背後にある「何を実現したいのか」という意図と、それを支える判断・制約・検証だった、と整理できます。チケットが守っていた中核は、作業(Task)よりも、その背後にある意図(Intent)だったとも言い換えられるのではないでしょうか。

AI時代のソフトウェア開発では、この「意図(Intent)」がより重要になってきていると感じます。

AIによって変わったこと

AI時代のソフトウェア開発では、単にコードを書くだけではなく、調査、分解、実装、テスト生成、レビュー補助、要約、トリアージ。ソフトウェア開発の周辺工程全体にAIが入り始めています。

象徴的な発信もあります。Linear は、2026 年 3 月 24 日にマーケティング上のメッセージとして "Issue tracking is dead." を打ち出しました*7。Linear によれば、従来のIssue trackingはPMが作業をスコープし、エンジニアが後から拾うハンドオフモデルのために作られたものだったとされています。今後のシステムは、ハンドオフではなく、文脈(context)とAIエージェント(agents)を中心に設計される、というのがLinearの主張です。

DORAの2025年の報告書も、AIは組織の既存の強みと弱みを増幅するものであり、AI導入による効果はツール単体ではなく組織システム全体に依存すると指摘しています*8。同報告書は、速度向上が下流の不安定さを露わにする、内部プラットフォーム品質がAI価値を決定づける、といった具体的な論点も提示しています。

ここから読み取れるのは、AI時代のボトルネックが、実装そのものから、意図の明確化、検証、責任分界へと移りつつある可能性です。
何を作るべきか、どこまで作るべきか、何を守るべきか、どうなれば正しいと言えるのか。そういった「意図(Intent)」こそが、より重要になっていく。このことはここ1, 2年で急速に共通認識になりつつあります。

なぜIntentが重要なのか

ここでいうIntentは、単なる目的文ではありません。

「なぜこれをやるのか」「何を満たせば成功か」「どこまでやれば終わりか」「どの制約を守るのか」「どんな副作用を避けたいのか」これらをまとめた、開発の起点です。

作業(Task)と意図(Intent)の違いを下記の表にまとめました。

Task Intent
粒度 作業単位 目的単位
寿命 完了したら閉じる 達成後も参照されることが多い
数 多い 少ない
主な担い手 AI エージェント 人間
役割 実行 判断・検証

AI時代にIntentの重要性が増すと考えられる理由は、AIが作業を高速・大量に実行できる場面が増えてきたからです。

人間の開発者であれば、曖昧なチケットでも文脈から意図を補完して、「たぶんこういうことだろう」と判断できます。AIも確認はできますが、人間より速く・大量にコードを生成できるため、曖昧な指示を誤って解釈してしまった場合に積み上がる量が桁違いに大きくなります。

そのため、AI時代には「実装できること」よりも、「意図に沿って実装されていること」の方が重要になっていくと考えています。

Taskは完了すれば閉じます。しかしIntentは、作業が完了した後も、後続の意思決定で参照されることが多い情報です。「なぜこれを作ったのか」「制約は何だったか」「どうなれば成功か」を、後から検証・参照できることが重要です。

この考え方に立つと、開発の中心にあるのが必ずしもチケットである必要はなくなります。

むしろ、これまでどおりチケットを中心に扱うと、Intentはチケット内に閉じ込められることになります。こういった方法では、複数のチケットやPRが同じIntentを参照する場面で、参照の起点がチケットの中に隠れてしまいます。また、チケットが閉じた後も生き続ける情報の追跡もしにくくなる問題もあります。

では、Intentを軸にすると、具体的にどういう情報の置き方になるのか。次節で見ていきます。

Intentを軸に、開発情報をつなげて考える

本稿では、大それた新しいシステムや大きな方法論を提案したいわけではありません。

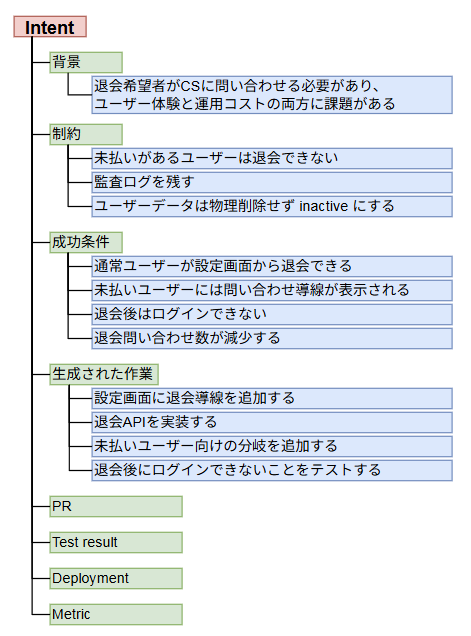
たとえば、ある改善について次のようなIntentがあったとします。

Intent:
ユーザーが問い合わせをせずに、自分で退会手続きを完了できるようにする

この Intent の周辺には、次のような情報が紐づきます。

例えばこういった形で必要な情報を管理可能です。

  • 背景や意思決定はNotionや設計ドキュメントに置けばよい
  • 作業単位や担当はLinearやGitHub Issuesに置けばよい
  • 実装の証跡はPRに残る
  • 検証結果はCIやテストレポートに残る
  • リリース状況はDeploymentに残る
  • 運用後の変化はメトリクスや外形監視で確認できる

情報を(従来のチケットのように)一箇所に集めてはいません。適切に残されたそれぞれの情報が、どのIntentに紐づいているのか。そのつながりを追えることが重要です。(ここで新しいシステム名や方法論を提案したいわけではありませんが、 便宜的に「Intent Graph的な構造」と呼ぶことはできそうです)

もちろん、これをきれいに整備するのは簡単ではありません。Intentを軸にして、開発に関わる情報をつなげて扱いたい、という思いはありつつも、私たち自身もこの形をきれいに整備できているわけではないのです。現実には、背景はNotionにあり、作業はLinearにあり、実装はGitHubのPRにあり、結果はアプリ上にあり、それらのつながりは人間の記憶に依存していることも多いのが実情です。

実運用上は、Intent IDをどこに置くかという規約と、ツール間のwebhookやリンクの整備が必要になります。メトリクスからIntentへの逆引き(ある数値変動がどのIntentに紐づくか)を機械的に追うのも、現状ではまだ弱い部分です。このあたりの人間の規律と運用コストの部分で課題は残りますが、今後あるべき姿としてはこういった構造なのではないか、と考えています。

※「Linearや Jira の階層機能(Initiative / Project / Issue / Sub-issue)で十分では?」と思われるかもしれません。
たしかに、既存ツールの組み合わせで近い構造は組めるはずです。そもそも、ある程度成熟したチーム・組織であれば、すでに似たようなことはやっているのではないかと思います。ただ、今あるツールをうまく使うよりもより良いUIがあれば、より広く実践される可能性はあると思います。

Ticket-firstからIntent-awareへ

昨今、チケットの構造化に関する話題が増えています。背景、目的、制約、非スコープ、受け入れ条件を今まで以上にきちんと書きましょう、という流れです。これは短期的には正しい方向です。曖昧なチケットは、曖昧な実装を生みます。AIは曖昧な指示に対しても、それらしい実装を高速に返してしまうことがあるため、目的と制約を明示する価値はむしろ高まります。

しかし中長期では、状況は変わってくると考えています。

「良いチケットを書きましょう」という議論は、チケットが開発の中心にあることを前提にしています。本当に考えたいのは、チケットというUIが、AI時代の開発における最適な中心であり続けるのか、という問いです。

チケットはこれまで、意図、作業、責任、進捗、検証、証跡を一枚にまとめる便利な箱でした。その便利さは、実装が遅く、ハンドオフが多く、文脈を一箇所に圧縮する必要があった時代には大きな価値を持っていました。

しかしAIが文脈を保持し、関連するIntent、過去の判断、制約、テスト結果を踏まえて作業できるようになると、すべてをチケットに書く必要は薄れていきます。

細かい実装ToDoは、AIエージェントが動的に生成するようになっていきます。進捗ステータスは、PRやCI/CDから自動観測される方向に進みます。バグ調査は、ログや監視アラートから直接AIエージェントが始める運用も、商用ツール(SentryのAutofix、DatadogのBits AI等)で部分的に現れ始めています。

仕様は、ドキュメントだけでなく、実行可能な仕様(executable spec)としてCIに組み込まれていきます。

一方で、人間の判断は残ります。何を作るべきか。なぜ今やるのか。どんな副作用を避けたいのか。法務・セキュリティ・倫理上、何を許容しないか。これらはIntentの領域であり、AIが代替するのは難しい部分です。

AIが高速に実装できるようになるほど、「何を作るか」よりも、「なぜ作るのか」「何を守るのか」「どうなれば成功なのか」が重要になります。DORA の 2025 年の報告書が指摘するように、速度向上は下流の不安定さを露わにし、その不安定さを支えるのは、内部プラットフォームの品質や、小さく変更を進める運用のような、組織システム側の力です*9。

だからこそ、これから必要なのは、チケットが担っていた役割を分解し、Intentを軸に再配置することです。Intentを意識して、ドキュメント、チケット、PR、テスト、監視、メトリクスをつなげていく方向に、少しずつ組み直していくことです。

その過程で、チケットは消えるのではなく、置かれる位置が変わると考えています。

チケットは、作業管理の唯一の中心ではなくなっていきます。作業の記録(record of work)であると同時に、Intentを軸につながった情報を、人間が見るための一つのビューになっていくのではないかと思います。

似顔絵
書いた人:伊藤

参考文献・引用元

*1:Bugzilla Project, "About - What is Bugzilla?", Bugzilla.org. URL: https://www.bugzilla.org/about/ (閲覧日: 2026-04-27)。Bugzilla が defect-tracking / bug-tracking system であり、bugs、problems、issues、enhancement、change requests を追跡するための仕組みである、という説明の出典です。

*2:Lloyd Montgomery, "Issue Tracking Ecosystems: Context and Best Practices," arXiv:2507.06704, 2025. URL: https://arxiv.org/abs/2507.06704 (閲覧日: 2026-04-27)。Issue Tracking Systems が requirements、development tasks、maintenance items などを扱う基盤であり、issue 間リンクや外部ツールとのリンクによって traceability を支える、という整理の出典です。

*3:Ryan Singer / Basecamp, "Bets, Not Backlogs," Shape Up, Chapter 7. URL: https://basecamp.com/shapeup/2.1-chapter-07 (閲覧日: 2026-04-27)。バックログを大きな重荷と捉え、古いアイデアの整理ではなく少数の well-shaped な options に bet する、という考え方の出典です。

*4:Edwards Nystrom, Dhitiwat Jongsuebchoke, Tim Storer, "Sciit: Embedding issue tracking in source control management," Science of Computer Programming, Vol. 206, Article 102628, 2021. DOI: 10.1016/j.scico.2021.102628. URL: https://doi.org/10.1016/j.scico.2021.102628 (閲覧日: 2026-04-27)。Issue tracker と SCM を分離して管理する摩擦、issue を SCM 内の first-class change control item として扱い、status や participants などを SCM の状態から推測する設計の出典です。

*5:GitHub, "Spec Kit Documentation," GitHub Pages. URL: https://github.github.com/spec-kit/ (閲覧日: 2026-04-27)。Spec-Driven Development が仕様を実行可能なものとして扱い、仕様が working implementation を直接生成するという説明、および intent-driven development の整理の出典です。

*6:Den Delimarsky, "Diving Into Spec-Driven Development With GitHub Spec Kit," Microsoft for Developers Blog, 2025-09-15. URL: https://developer.microsoft.com/blog/spec-driven-development-spec-kit (閲覧日: 2026-04-27)。AI agent に正しい出力を出させるには良い context が必要であり、何をなぜ作るのかを決めないまま進めると codebase が de-facto specification になる、という説明の出典です。

*7:Linear, "Issue tracking is dead," Linear.app/next, 2026-03-24. URL: https://linear.app/next (閲覧日: 2026-04-27)。従来の issue tracking が PM からエンジニアへの handoff model に合わせて作られたこと、今後は context と agents を中心に開発システムが変わる、という主張の出典です。

*8:DORA / Google Cloud, "State of AI-assisted Software Development 2025," DORA Research, 2025. URL: https://dora.dev/dora-report-2025/ (閲覧日: 2026-04-27)。AI は組織の既存の強みと弱みを増幅するものであり、AI 導入の効果はツール単体ではなく組織システムに依存する、という整理の出典です。

*9:DORA / Google Cloud, "State of AI-assisted Software Development 2025," DORA Research, 2025. URL: https://dora.dev/dora-report-2025/ (閲覧日: 2026-04-27)。AI は組織の既存の強みと弱みを増幅するものであり、AI 導入の効果はツール単体ではなく組織システムに依存する、という整理の出典です。